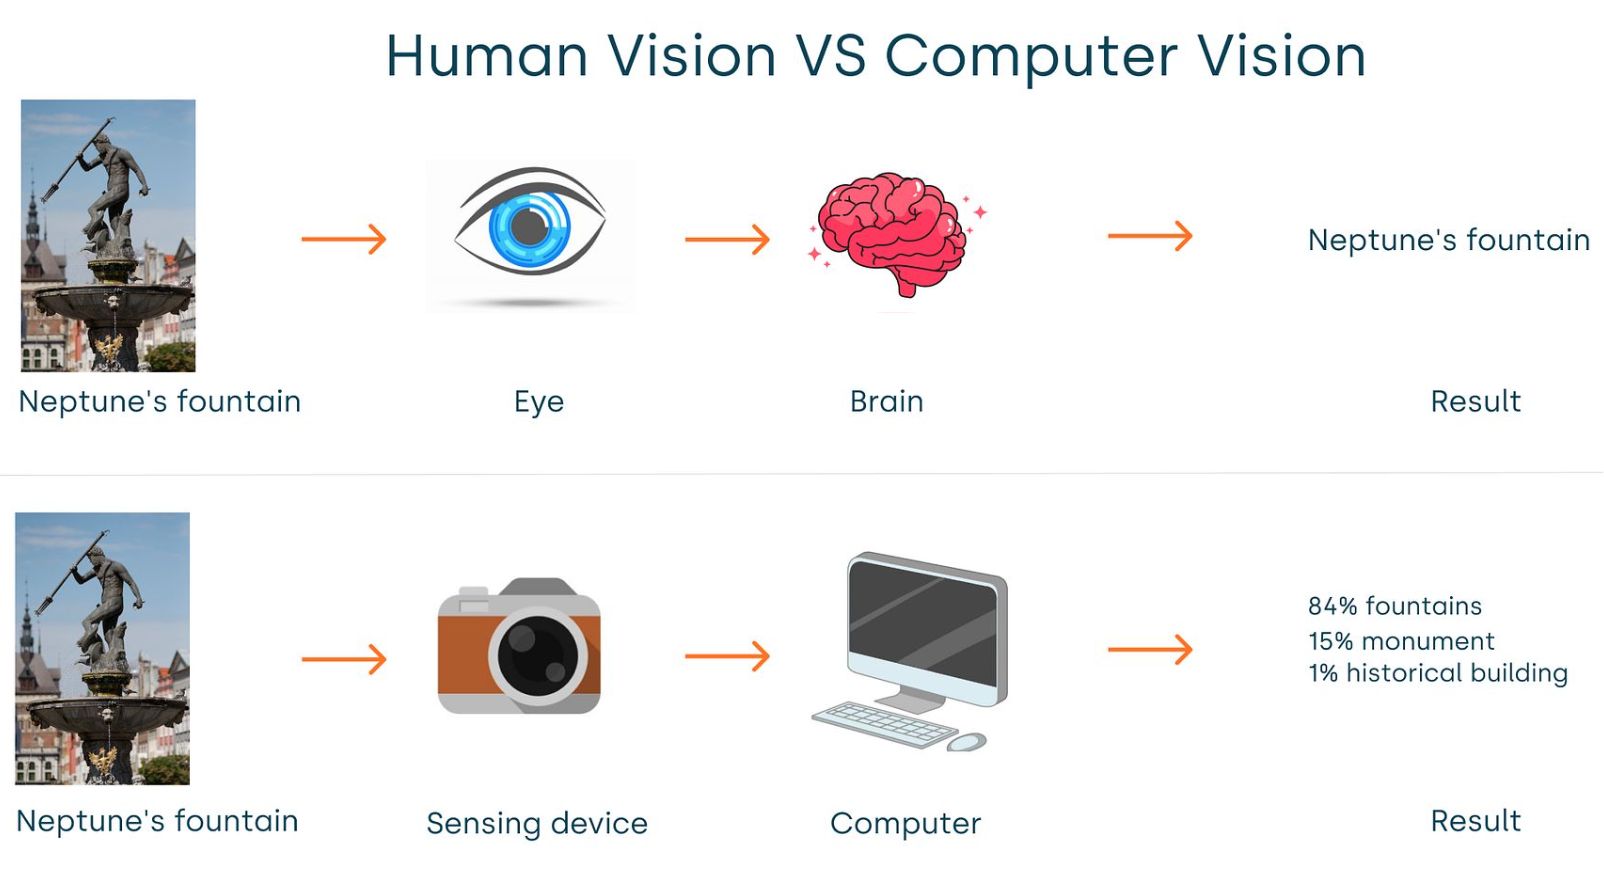
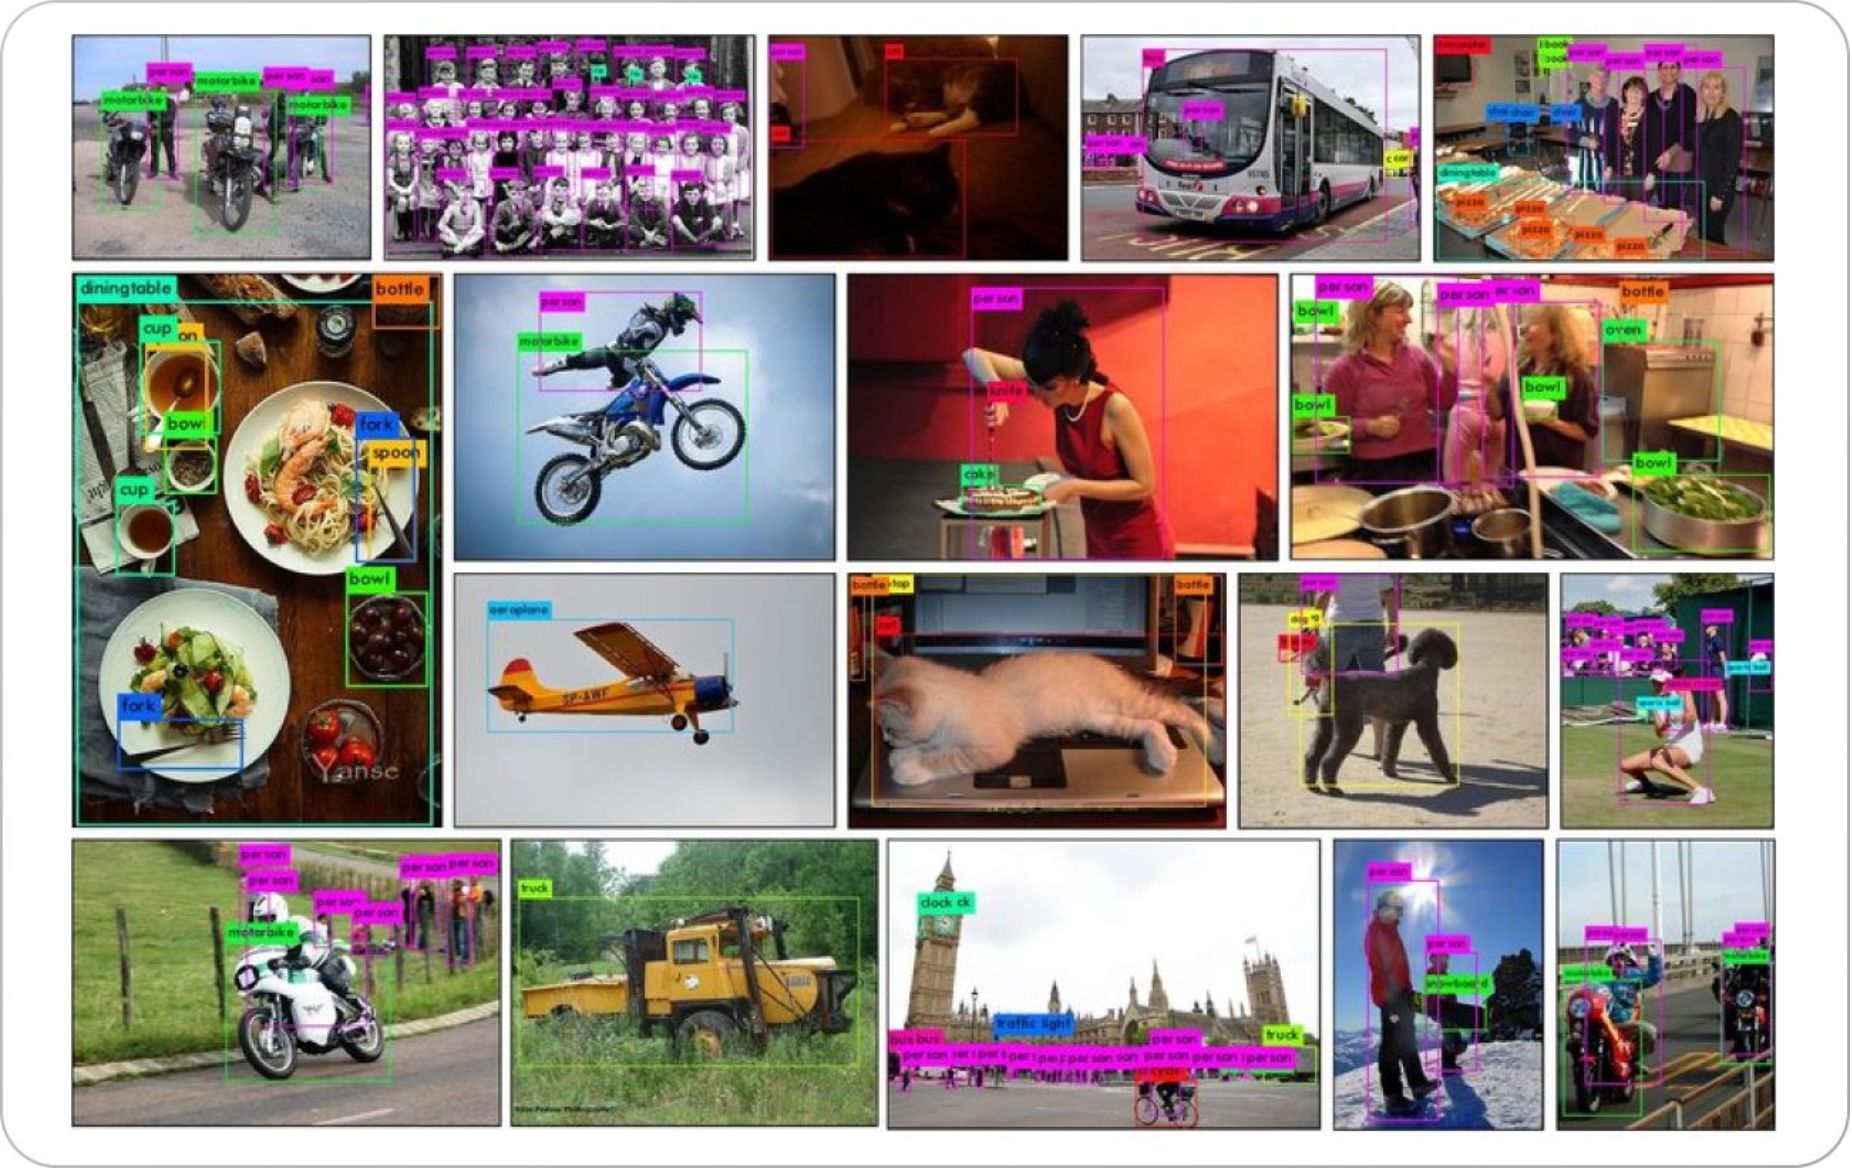
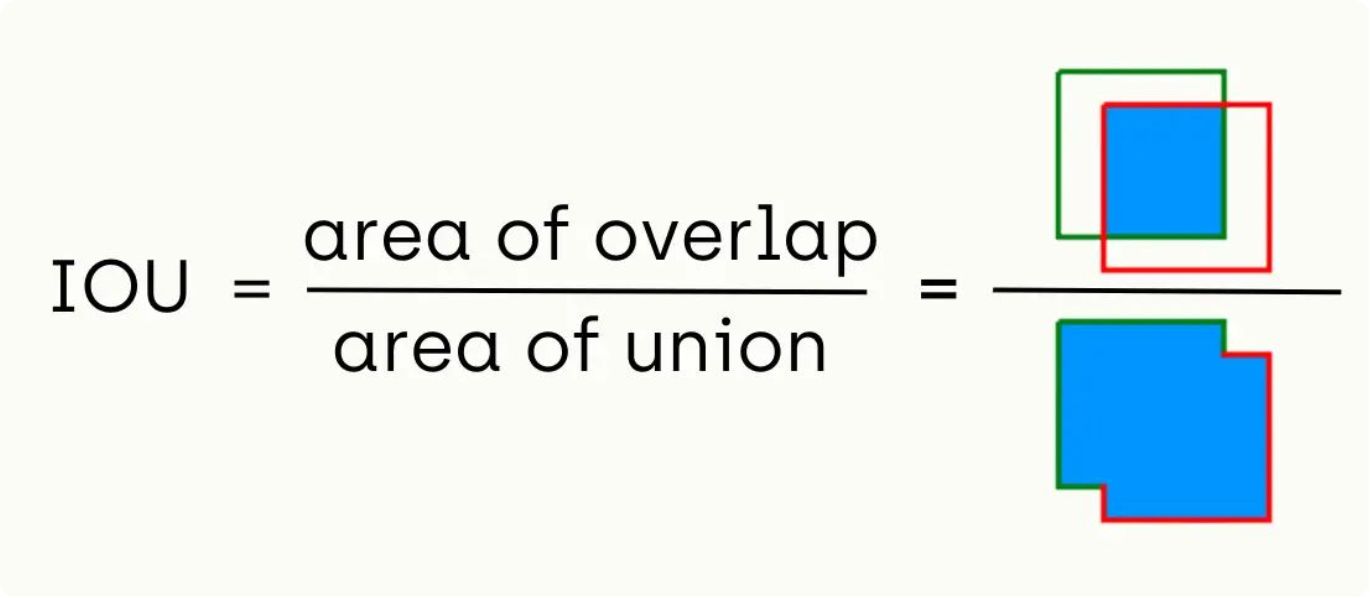La visión artificial es la disciplina de la inteligencia artificial que busca capacitar a las máquinas para extraer información significativa y comprender el mundo a partir de imágenes y vídeos digitales, imitando la percepción humana.
Inmediatamente identificamos «un gato naranja durmiendo en un sofá» y comprendemos su contexto.
Una máquina percibe una compleja matriz de millones de píxeles, cada uno con valores numéricos RGB como [255, 128, 64…].
Las imágenes digitales son matrices de píxeles. La visión artificial aprende representaciones que permiten asociar esos valores con objetos, relaciones o regiones.
Asigna una etiqueta a la imagen entera: dice qué hay, no dónde.
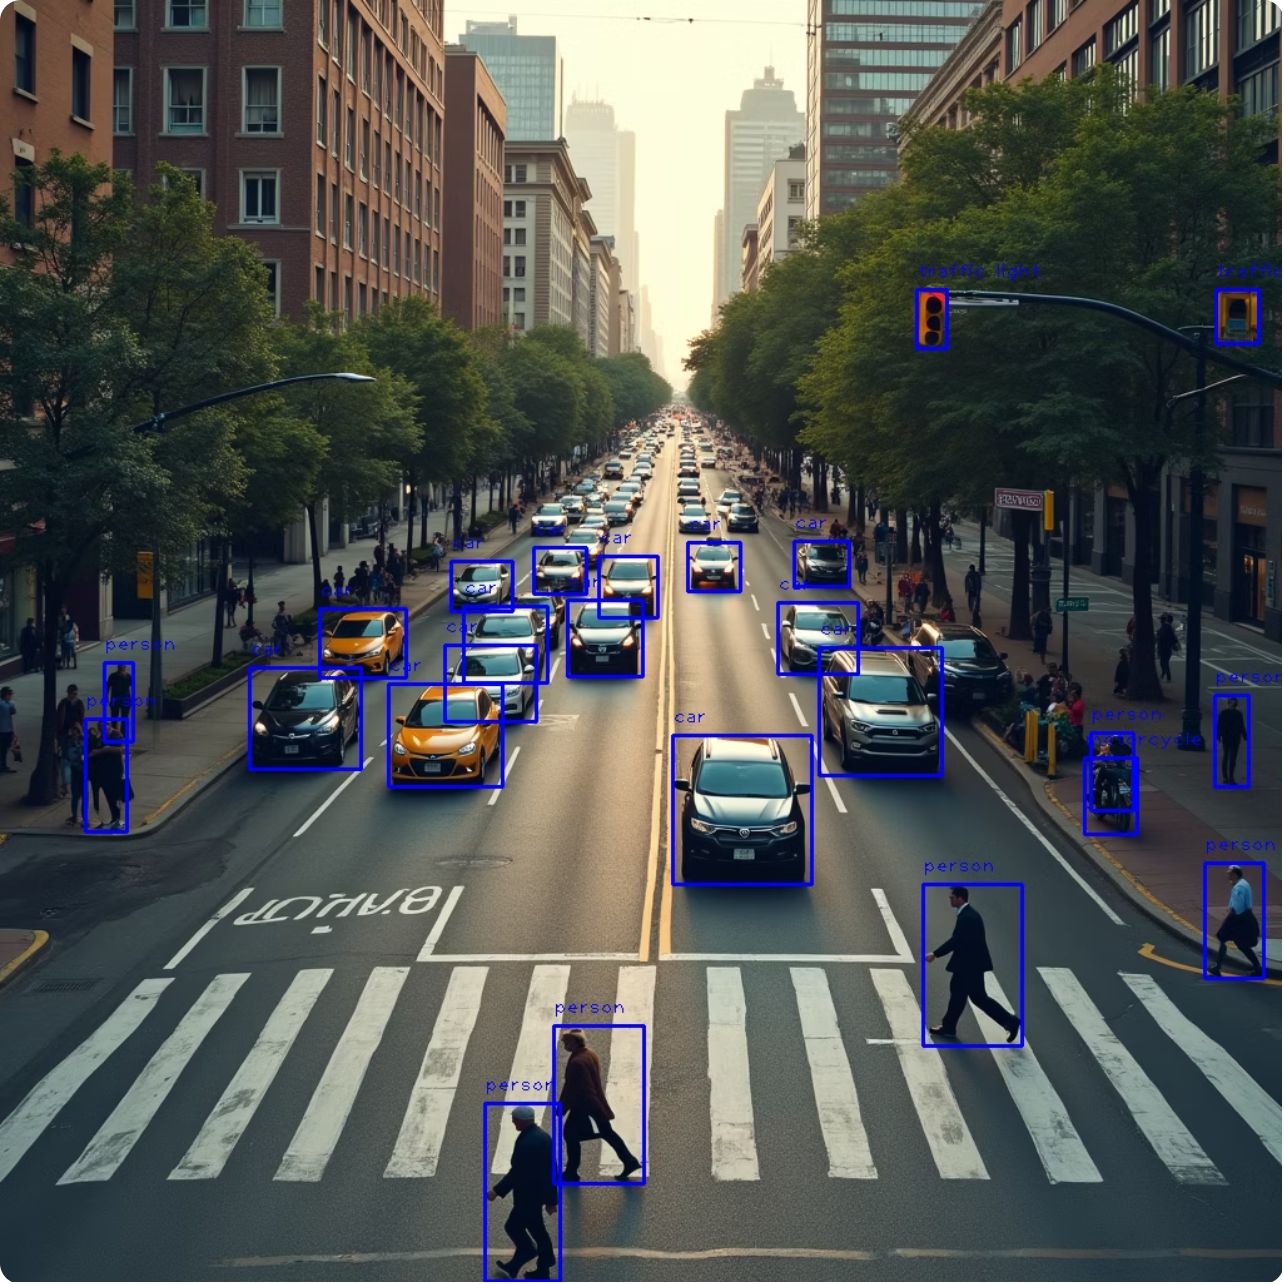
Encierra cada objeto en un recuadro delimitador y le asigna una clase.
Define el contorno exacto de cada objeto a nivel de píxel.
Identifica eventos o datos inusuales que no coinciden con un patrón esperado.
Localiza puntos clave (articulaciones) en personas o animales para comprender su postura.
OCR, estimación de profundidad, superresolución, keypoint matching…
La misma imagen admite tareas distintas.
Respuesta B. Exacto: la detección localiza cada instancia y permite contarla.
La clasificación da una etiqueta global. La detección devuelve cajas y categorías por instancia. La segmentación delimita píxeles. Otros problemas incluyen anomalías, pose, OCR, profundidad y superresolución.
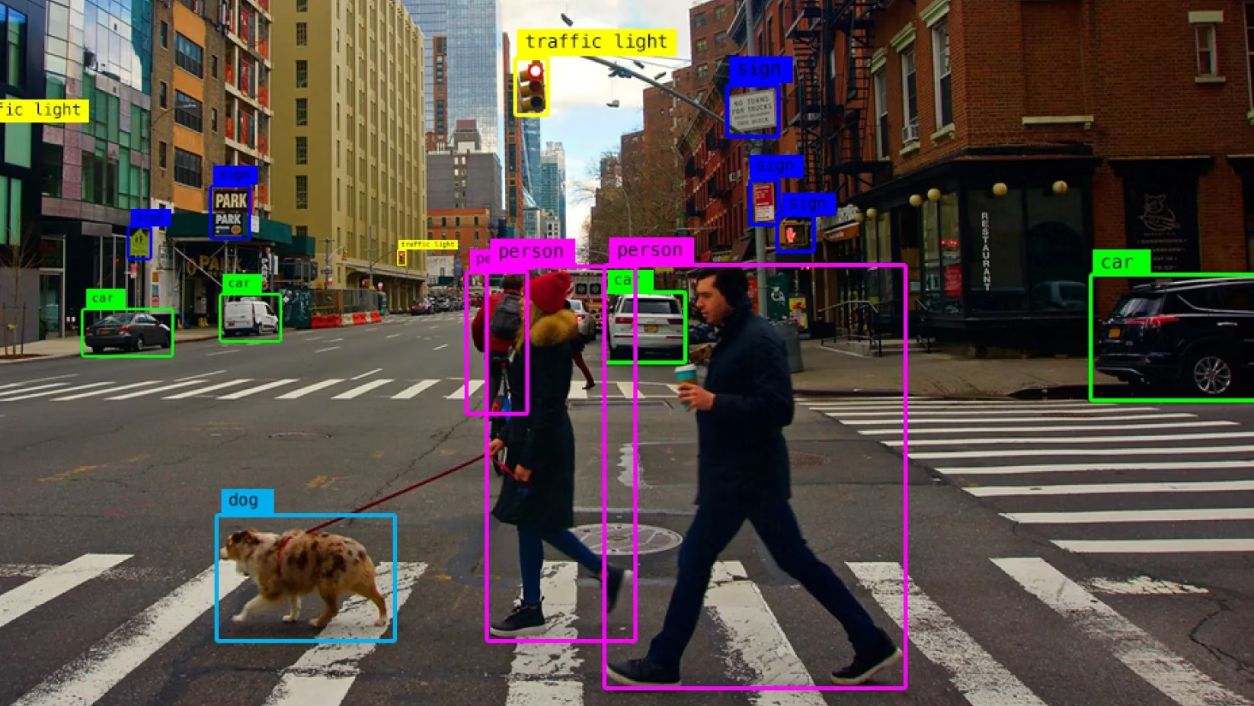
La detección de objetos va más allá de la simple clasificación. Su objetivo principal es localizar y clasificar múltiples objetos simultáneamente dentro de una imagen, proporcionando para cada uno una caja delimitadora, su categoría y una puntuación de confianza.
En qué se diferencia de las otras tareas:
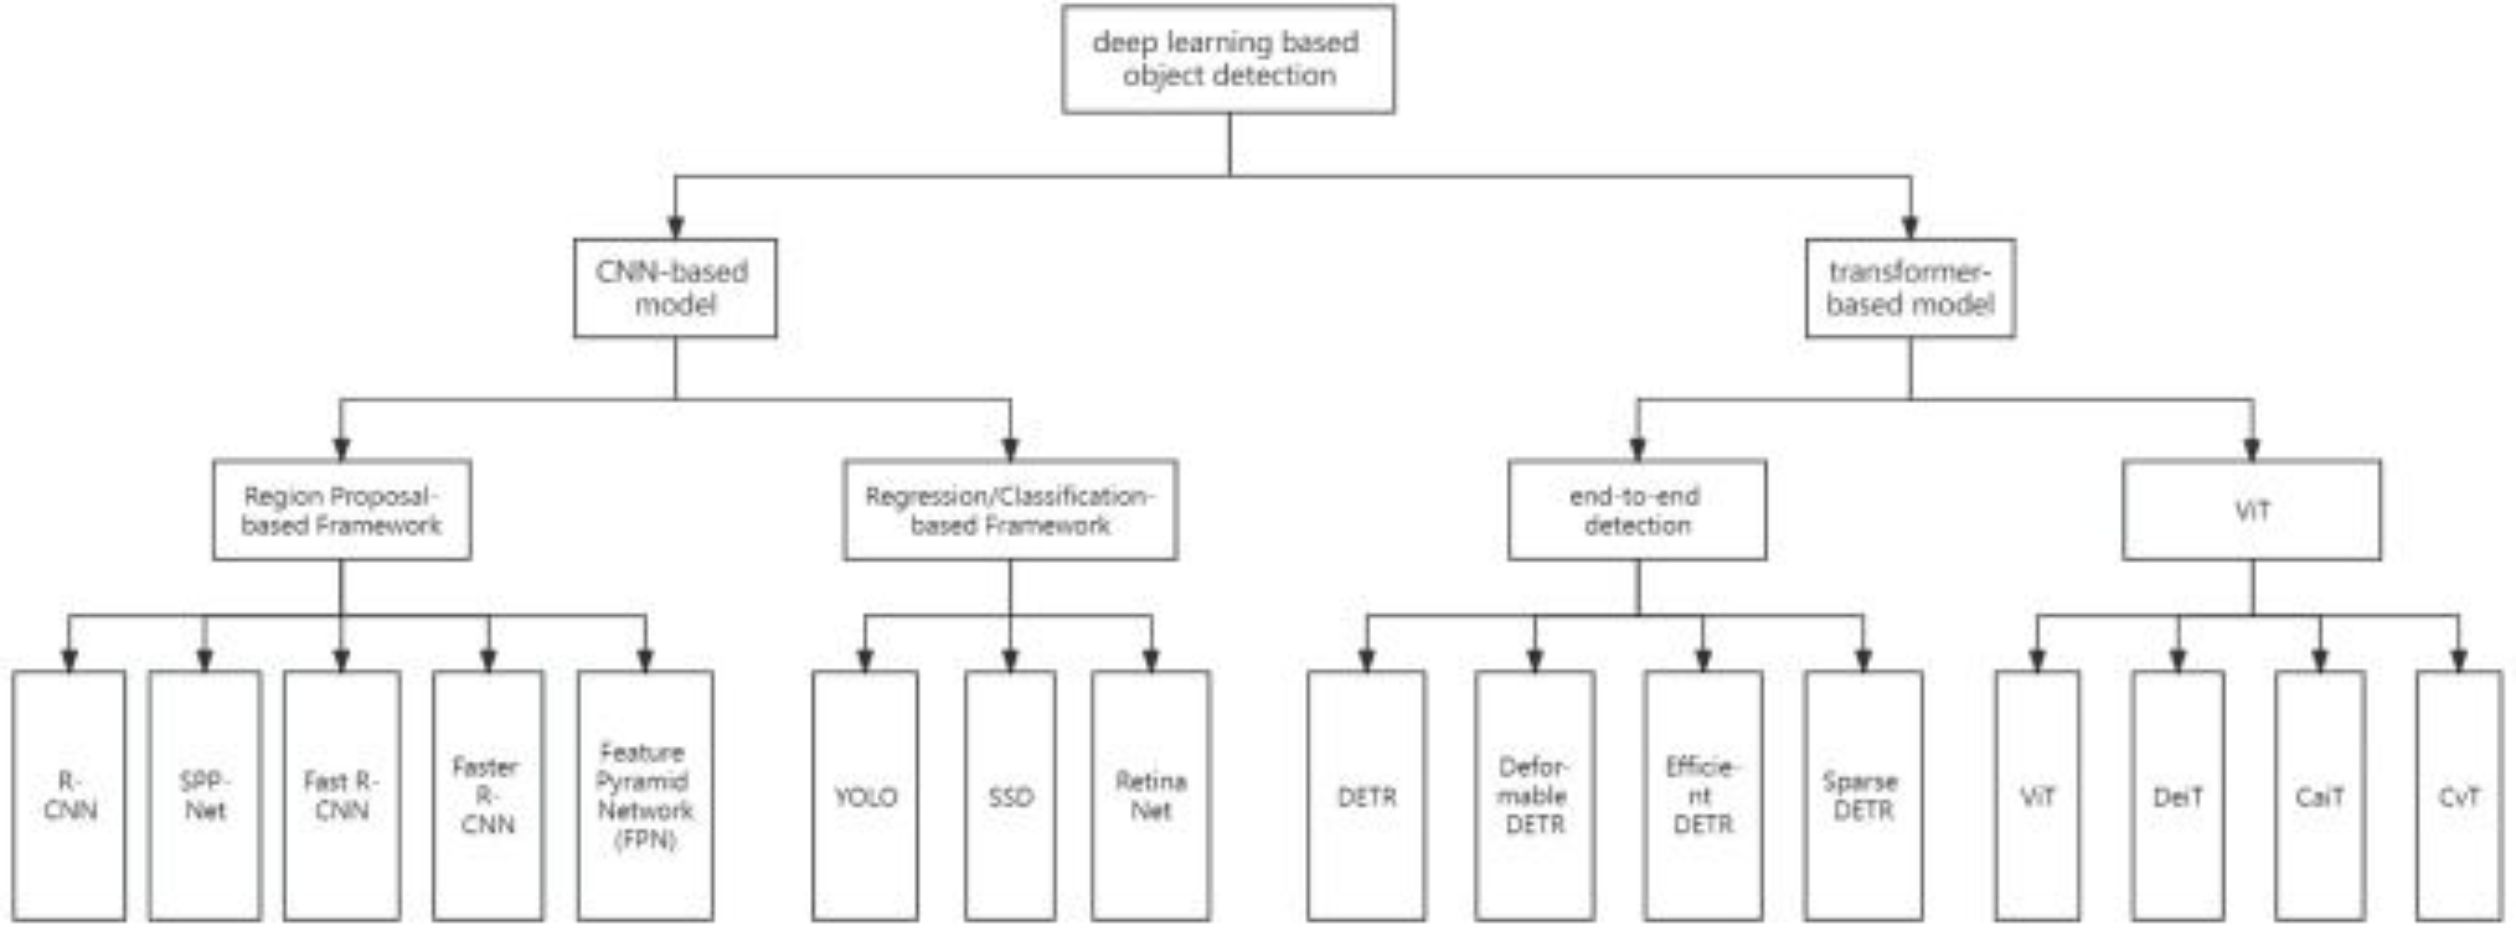
Hay muchas arquitecturas de detección. Estas son las familias principales.
La rama basada en CNN se divide en frameworks con propuestas de región (R-CNN, SPP-Net, Fast R-CNN, Faster R-CNN, FPN) y frameworks de regresión o clasificación directa (YOLO, SSD, RetinaNet). La rama basada en transformer agrupa detección extremo a extremo (DETR, Deformable DETR, Efficient DETR, Sparse DETR) y arquitecturas ViT (ViT, DeiT, CaiT, CvT).
Los modelos de detección de objetos han cambiado mucho en la última década. Nos centraremos en tres grandes etapas arquitectónicas.
R-CNN, Fast R-CNN, Faster R-CNN: arquitecturas de dos etapas que primero proponen regiones candidatas y luego las clasifican. Precisos pero complejos y lentos.
YOLO cambia el planteamiento: una sola red neuronal procesa la imagen completa en tiempo real, prediciendo cajas y clases simultáneamente mediante una cuadrícula.
DETR y RF-DETR: pipelines limpios basados en atención, sin anchors predefinidos ni supresión de no máximos (NMS). Arquitectura más simple y generalizable.
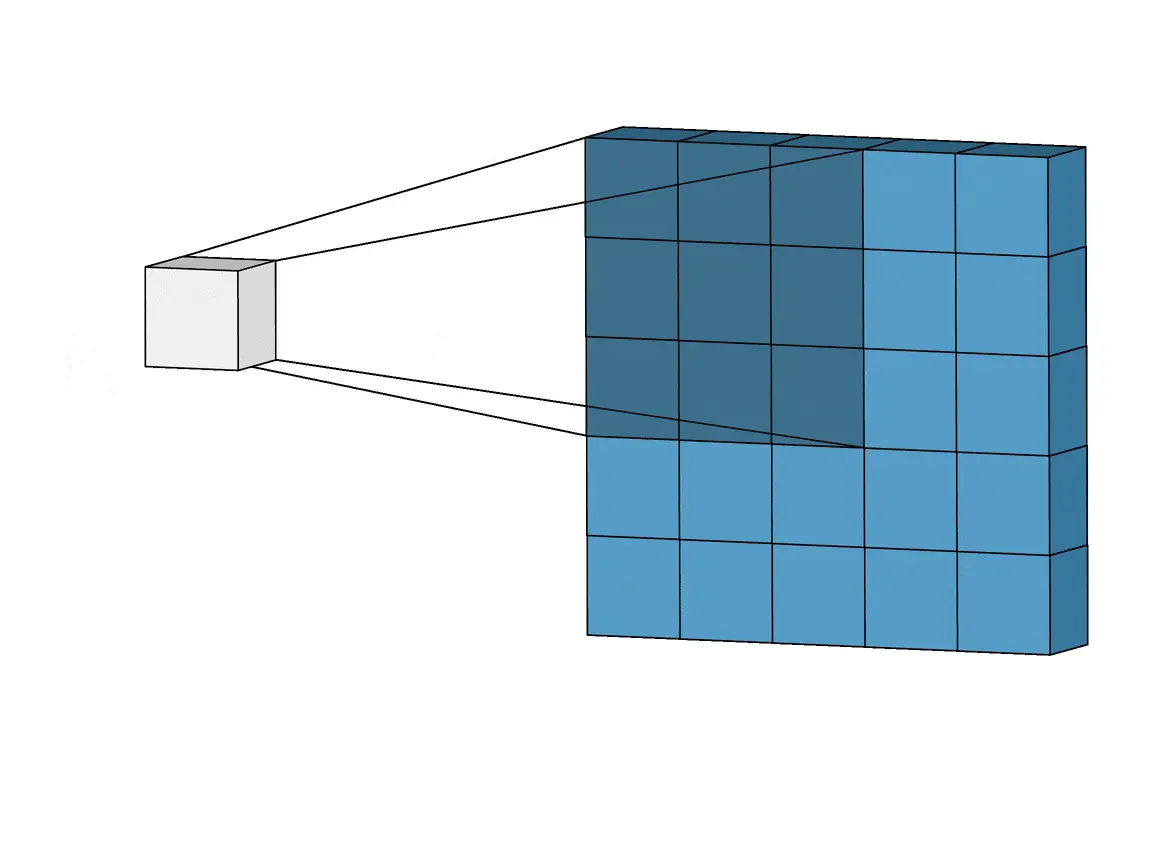
Las redes neuronales convolucionales (CNN) son la base de casi todos los detectores anteriores a 2020 y siguen dentro de muchos actuales. Procesan la imagen directamente con capas que detectan, de forma jerárquica, bordes, texturas y patrones cada vez más complejos.
Al apilar capas, la red pasa de detectar bordes a reconocer partes de objetos y objetos enteros, sin que nadie programe esas características a mano.
Las CNN incorporan localidad e invariancia aproximada a traslaciones. Siguen dentro de muchos detectores actuales, y una CNN también capta contexto global si se le añaden capas de atención o un campo receptivo grande.
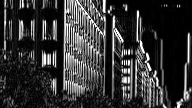
Un filtro de 3 × 3 recorre la imagen: cada píxel de salida es la suma de sus nueve vecinos multiplicados por nueve pesos. Cambia el filtro y mira qué se enciende; toca o pasa el ratón por las imágenes para ver la cuenta.
Se encienden los cambios de luz de izquierda a derecha: las aristas verticales de los edificios. El cielo, liso, queda negro.
Filtros escritos a mano y calculados en tu navegador. Una CNN aprende sus pesos durante el entrenamiento, y los de su primera capa acaban pareciéndose a estos.
Esta página recoge el filtro de bordes verticales: pesos negativos a la izquierda y positivos a la derecha, de modo que la suma es grande donde la luz cambia en horizontal y cero en las zonas lisas. En el punto marcado, sobre una arista del edificio de la izquierda, la salida vale 419. El filtro de bordes horizontales es el mismo girado 90 grados y enciende cornisas y filas de ventanas. El desenfoque promedia los vecinos y el realce resta los vecinos al centro. Una capa convolucional aplica decenas de filtros como estos a la vez, y las capas siguientes combinan sus mapas para detectar texturas, partes y objetos.
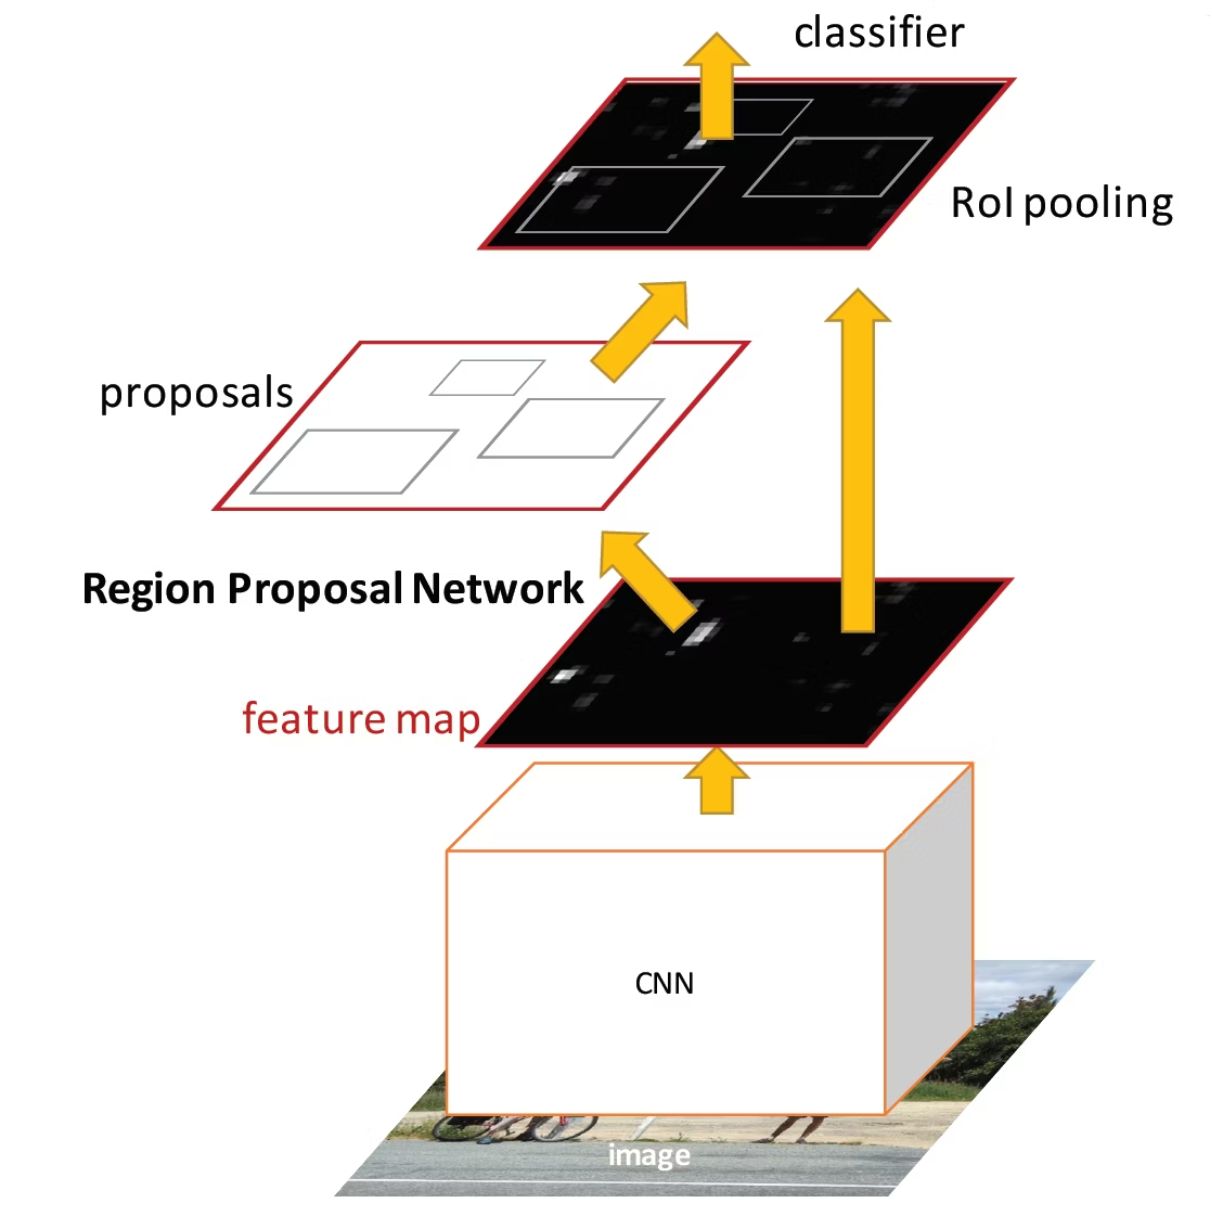
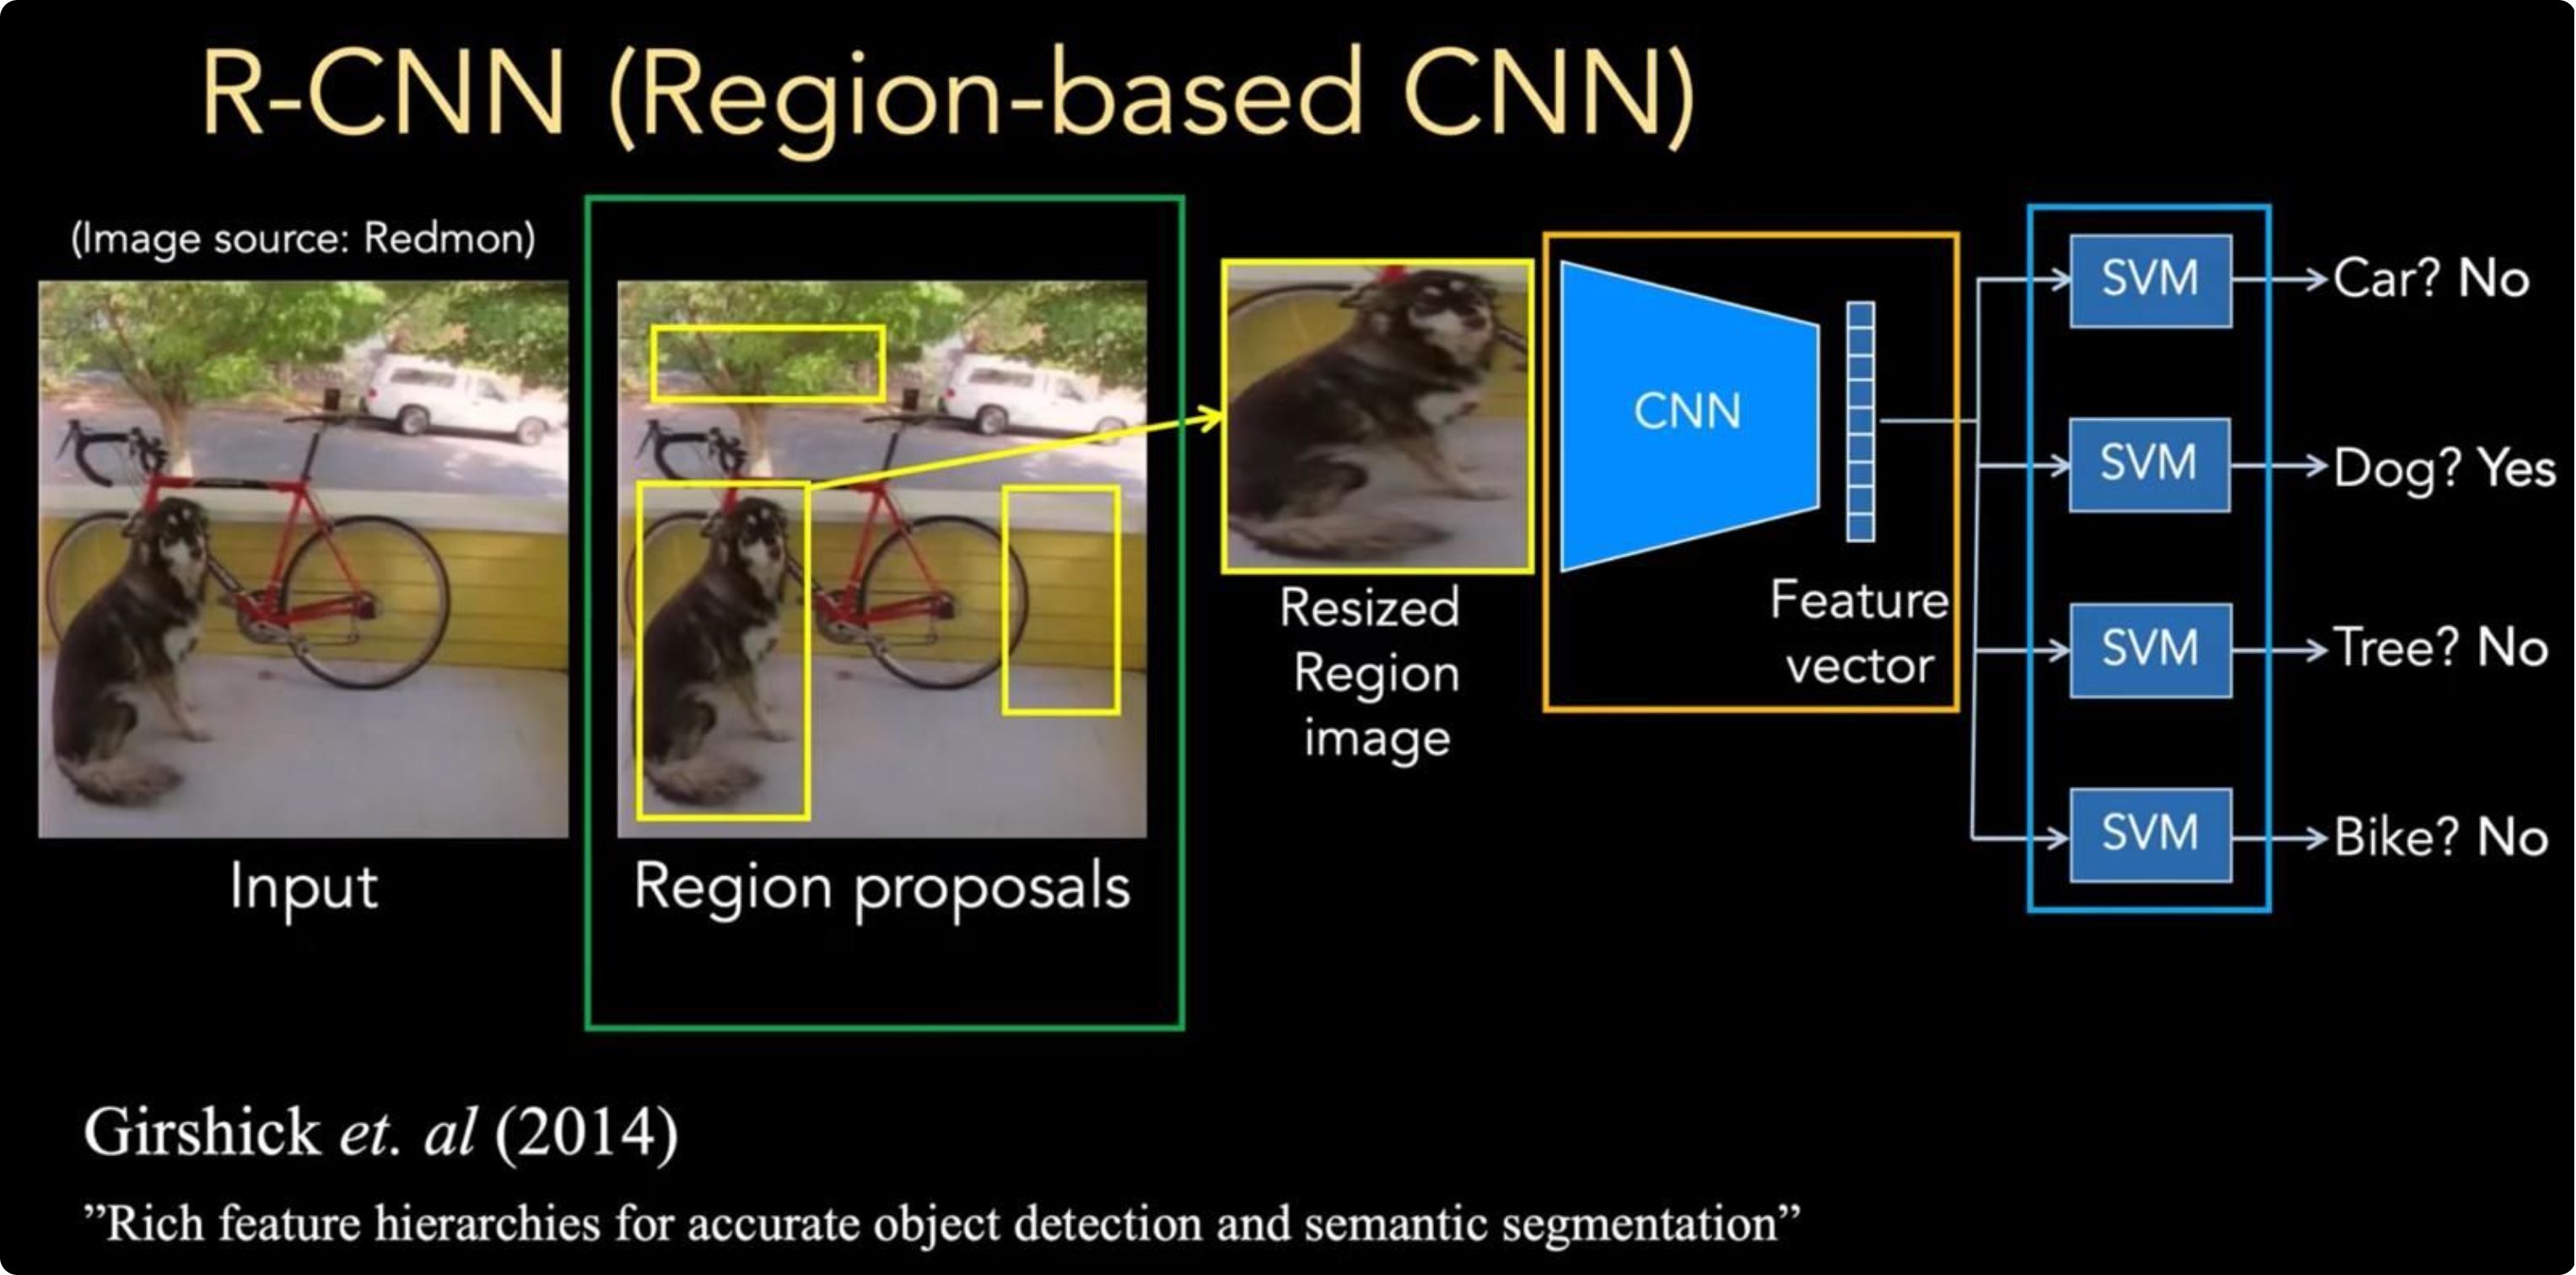
Los detectores de dos etapas, como la familia R-CNN, dividen el problema en dos fases secuenciales: primero generan propuestas de regiones candidatas (lugares donde podría haber objetos), y luego clasifican y refinan cada propuesta.
ROI Pooling acelera el proceso al extraer features de forma eficiente, pero el pipeline sigue siendo computacionalmente costoso. La generación inicial de regiones puede proponer cientos de candidatos, ralentizando la inferencia.
Trade-off característico: excelente precisión en benchmarks, pero latencia elevada para aplicaciones en tiempo real. Ideales cuando la exactitud es más importante que la velocidad. Difícil de optimizar.
Region proposal + CNN + clasificador.
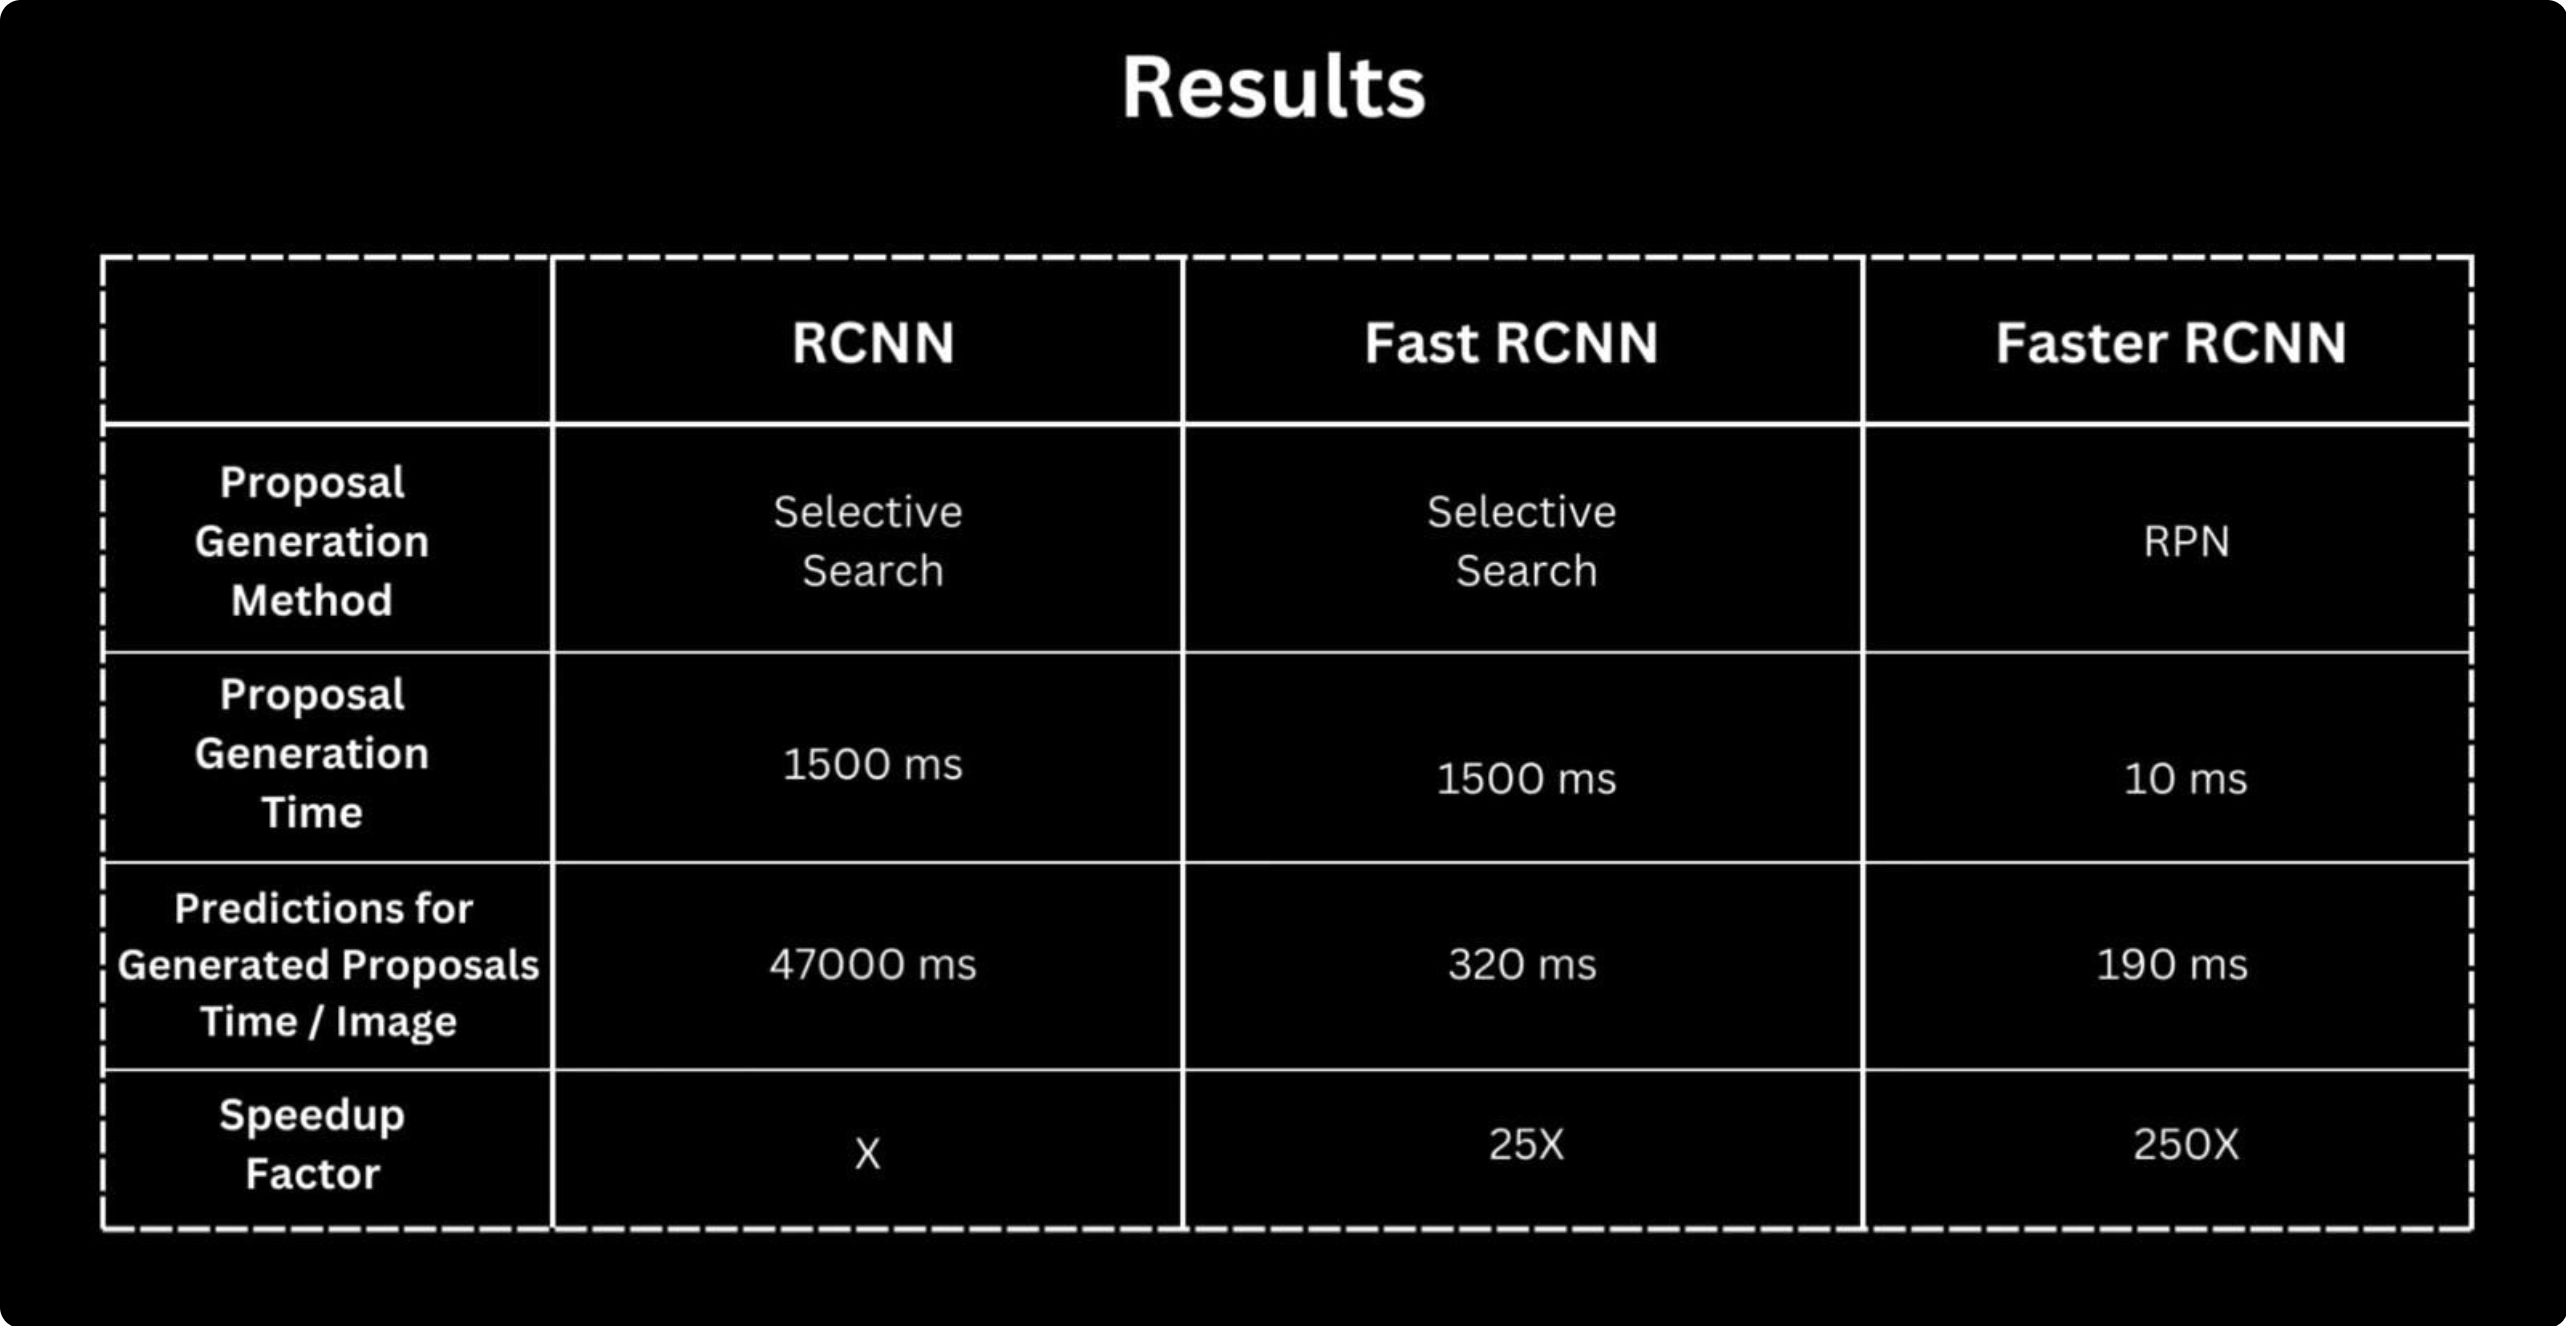
La tabla compara tres generaciones. Método de propuestas: Selective Search en RCNN y Fast RCNN, RPN en Faster RCNN. Tiempo de generación: 1500 ms, 1500 ms y 10 ms. Predicción sobre las propuestas por imagen: 47000 ms, 320 ms y 190 ms. Factor de aceleración: 1×, 25× y 250×.
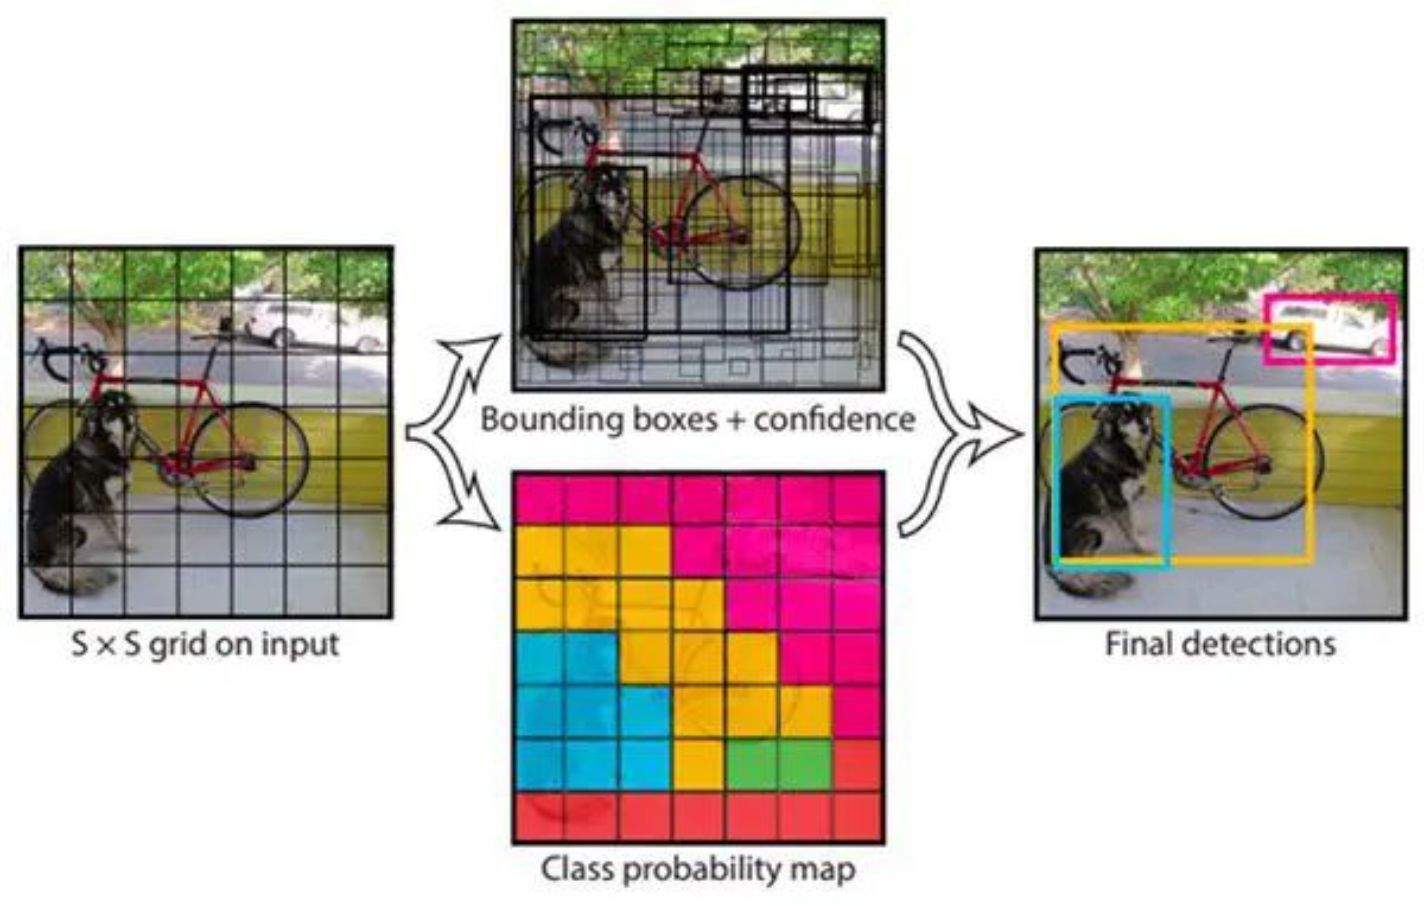
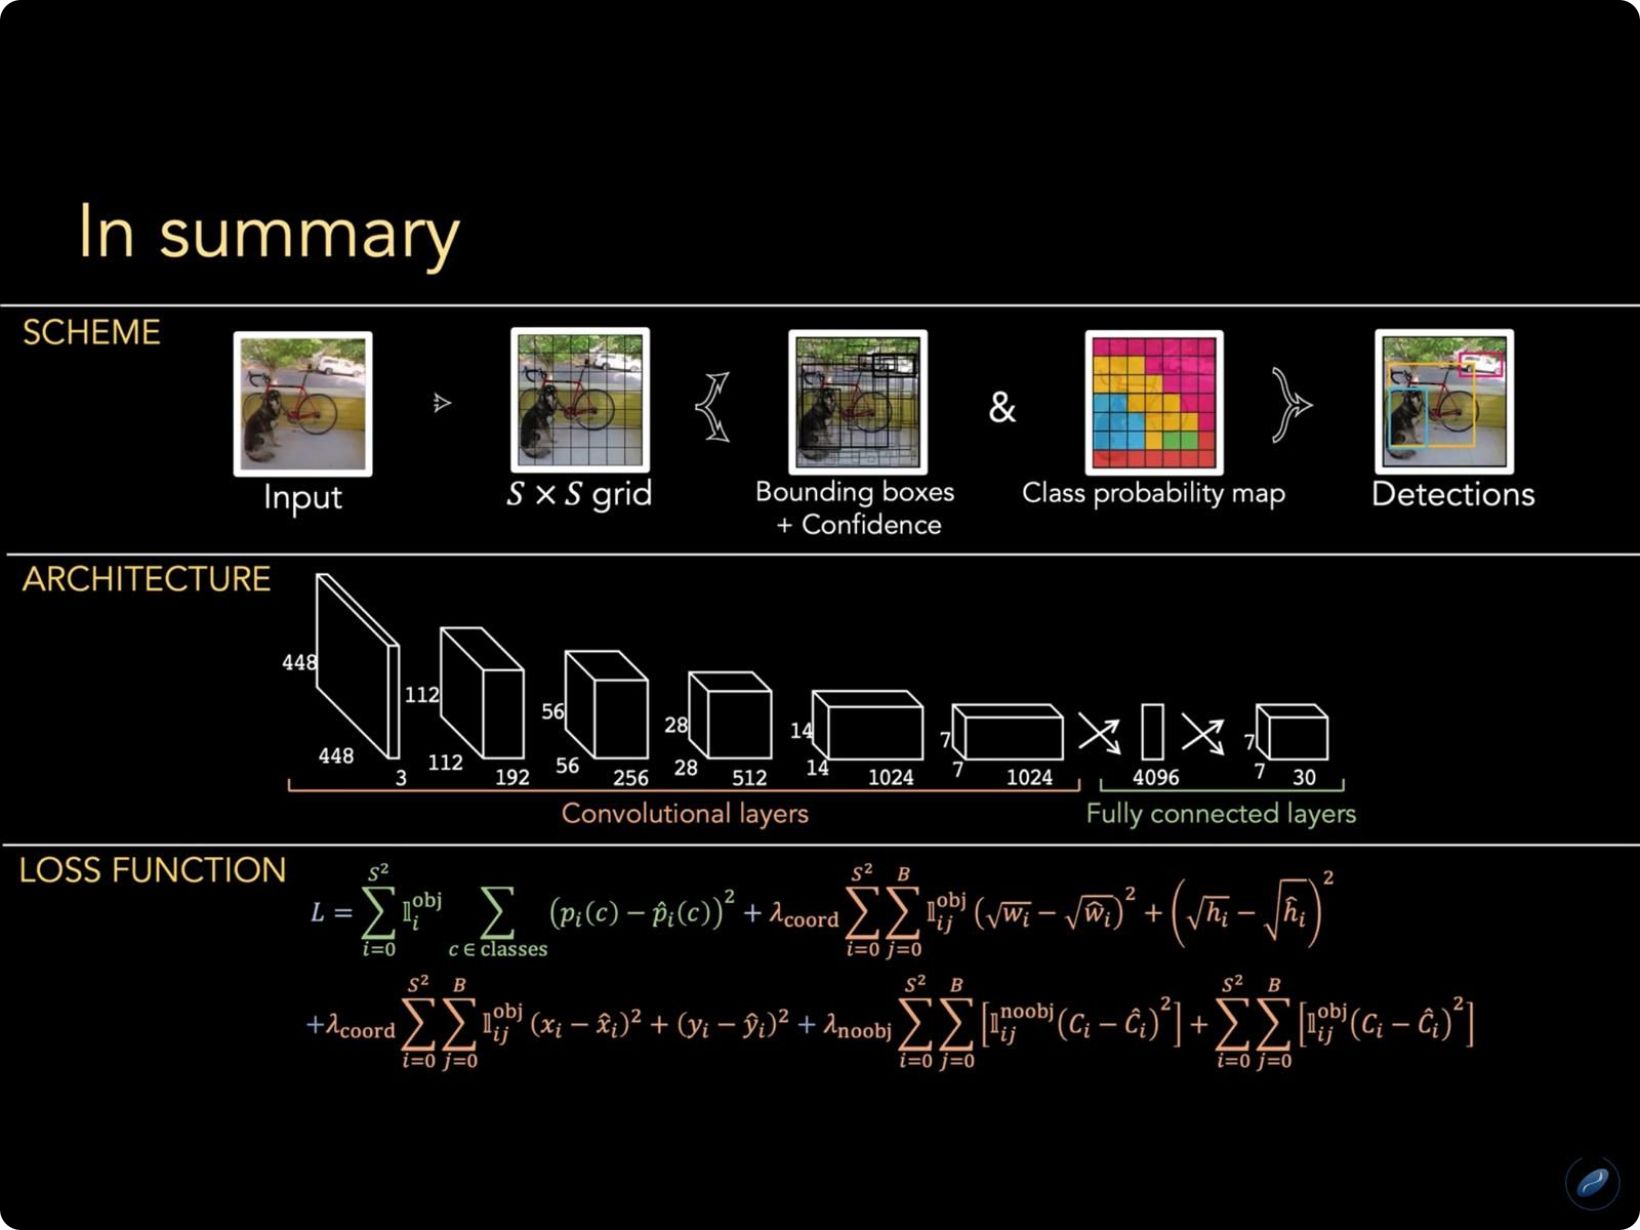
YOLO (You Only Look Once) reformula la detección como un problema de regresión único. La imagen se divide en una cuadrícula S×S, donde cada celda predice directamente las cajas delimitadoras y las probabilidades de clase de los objetos cuyo centro cae en ella.
La ventaja: una única pasada hacia adelante por la red permite velocidades de procesamiento en tiempo real (30+ FPS), manteniendo precisión competitiva. Esta arquitectura one-stage elimina la necesidad de generar propuestas de región por separado.
Cómo el modelo procesa la imagen en una sola pasada («You Only Look Once»).
YOLO divide la imagen de entrada en una cuadrícula. Si el centro de un objeto cae en una celda específica, esa celda es la responsable de detectarlo.
Cada celda predice recuadros (bounding boxes) con su ubicación, tamaño y nivel de confianza, y la categoría del objeto (mapa de probabilidad), todo al mismo tiempo.
Una única Red Neuronal Convolucional (CNN) procesa la imagen completa, conectando directamente los píxeles de entrada con las coordenadas y clases de salida, eliminando etapas intermedias complejas.
Baja la cuadrícula y mira qué pasa cuando dos centros caen en la misma celda.
Cada punto es el centro de un objeto. YOLOv1 usaba una cuadrícula de 7 × 7.
Objetos con celda propia3 de 3
Cada objeto cae en una celda distinta: la cuadrícula puede hacerse cargo de todos.
Esta página recoge el estado con una cuadrícula de 7 × 7, la que usaba YOLOv1. Al bajar a 6 × 6 o menos, los centros de los dos coches de la izquierda caen en la misma celda y esa celda solo puede responsabilizarse de uno: es la limitación más citada de YOLOv1 con objetos juntos o pequeños. Subir S reparte mejor los centros en general, pero no lo garantiza: con 8 × 8 y con 12 × 12 esos dos centros vuelven a caer juntos, porque lo que decide es dónde quedan las líneas de la rejilla. Además, más celdas multiplican las predicciones y el coste. Las versiones posteriores atacan el problema con predicción multiescala y, más tarde, con enfoques anchor-free.
Comprueba en qué se diferencia un detector de una etapa.
Respuesta C. Exacto: esa es la idea central, aunque los detalles cambian entre versiones.
Un detector de una etapa predice cajas y clases en una única pasada sobre toda la imagen, sin una fase previa que proponga regiones candidatas.
Diez años de versiones publicadas por grupos distintos. El número no indica quién hizo cada modelo ni que herede el código del anterior.
Las CNN cambiaron la visión artificial, pero tienen límites de arquitectura que se notan cuando importan los objetos alejados entre sí o las relaciones espaciales que no son evidentes.
Las CNN procesan información en parches locales. Para entender relaciones a larga distancia, necesitan muchas capas, lo que aumenta la profundidad del modelo y dificulta la propagación de gradientes. Esto es ineficiente para capturar el contexto global de una imagen.
Asumen una fuerte localidad espacial e invarianza a traslación. Esto es útil para objetos que aparecen en cualquier lugar de la imagen, pero dificulta la modelización de relaciones abstractas o estructuras que no se ajustan a patrones de vecindad directa.
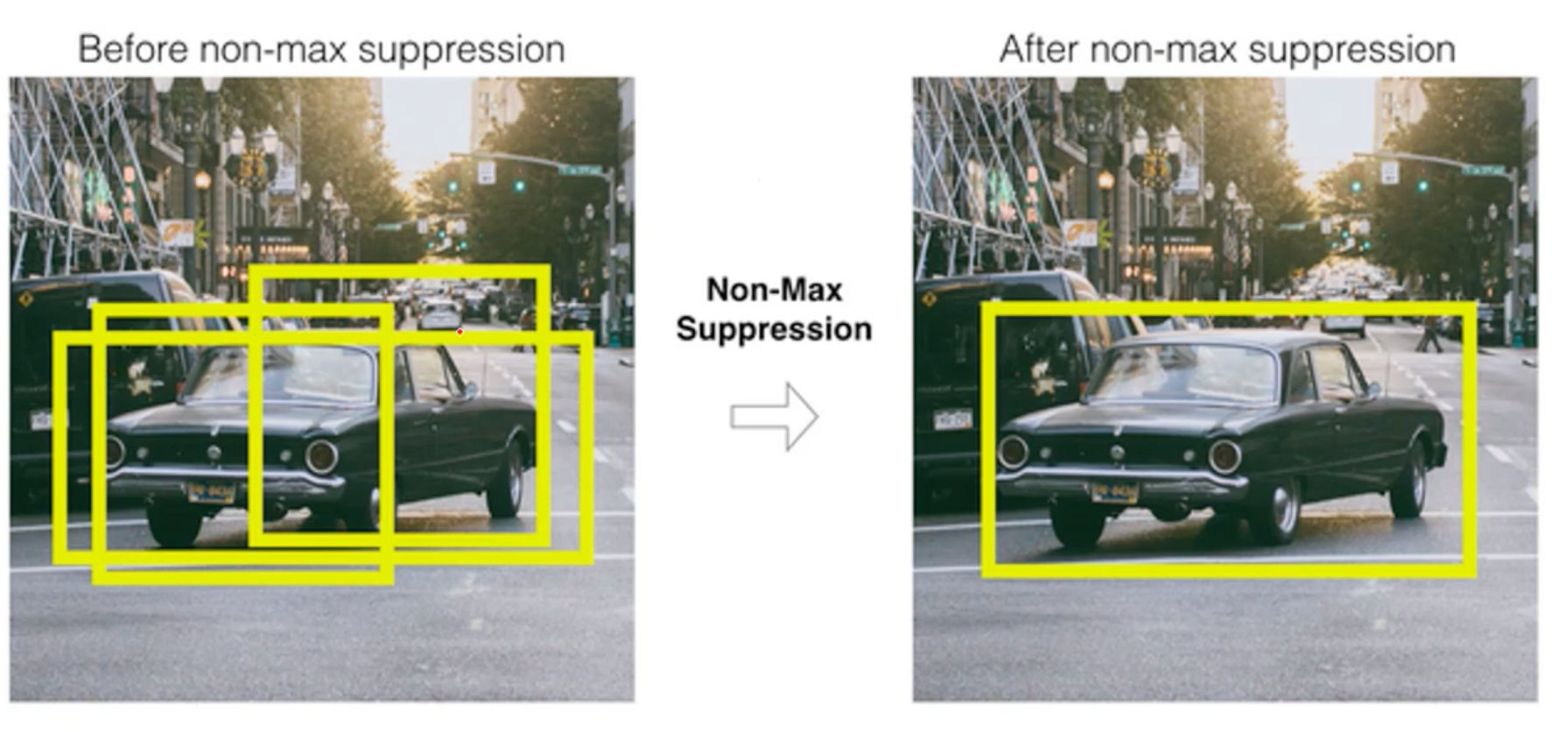
Los detectores basados en CNN dependen de piezas manuales y heurísticas, como los «anchors» predefinidos (cajas de distintos tamaños y proporciones) y la supresión de no máximos (NMS) para eliminar duplicados. Estas piezas añaden complejidad e hiperparámetros, y no se optimizan junto con el resto de la red.
El NMS mide cuánto se solapan dos cajas (su IoU, que se define unas pantallas más adelante). Baja el umbral y desaparece un coche entero; súbelo y vuelven los duplicados.
Cinco cajas candidatas sobre dos coches. El detector las propone todas antes de filtrar.
Cajas que quedan2
Suprimidas3
Una caja por coche: el umbral limpia los duplicados sin borrar objetos.
Esta página recoge el estado con umbral 0,50. El algoritmo recorre las cajas de mayor a menor puntuación: cada superviviente suprime a las que solapan con ella por encima del umbral. Con 0,20 la caja del primer coche llega a suprimir la del segundo, porque comparten un 25 % de área, y se pierde un objeto real. Con 0,80 apenas se suprime nada y quedan las cinco cajas. No hay un valor universalmente correcto: depende de cuánto se solapen los objetos del dominio, y por eso DETR y RF-DETR eliminan este paso mediante la asignación uno a uno durante el entrenamiento.
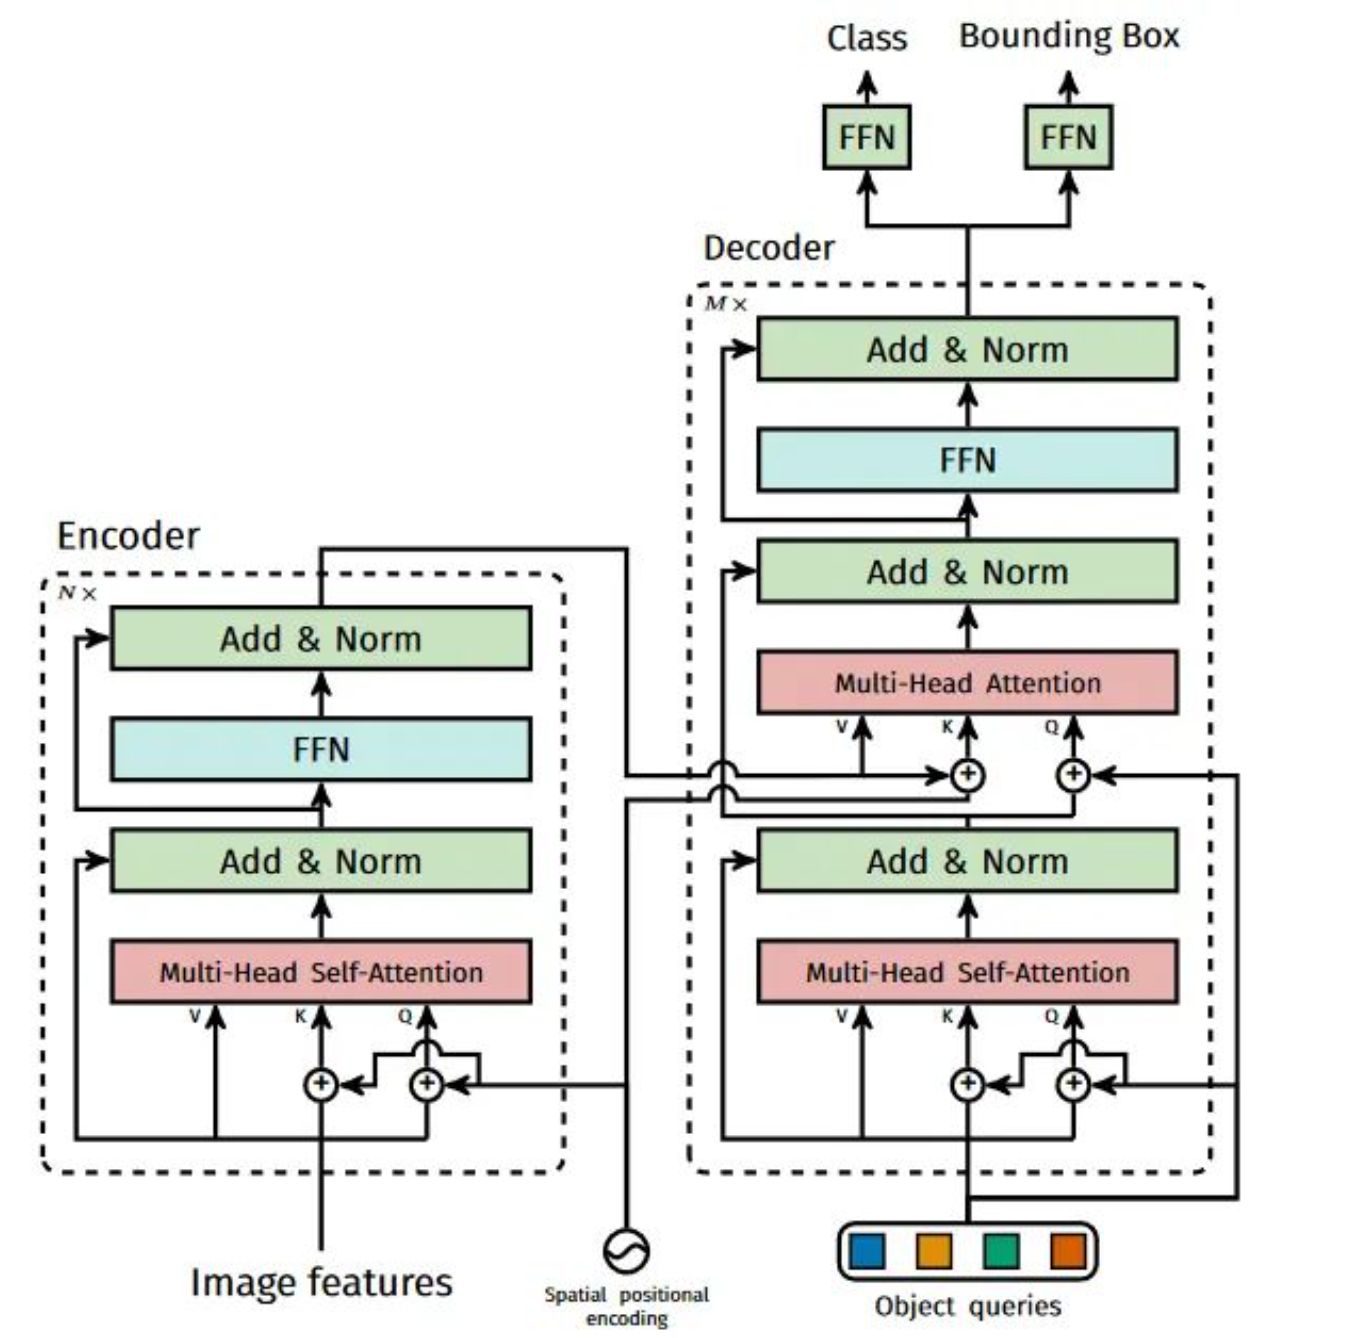
DETR (DEtection TRansformer, Carion et al., 2020) trata la detección como la predicción directa de un conjunto: una arquitectura encoder-decoder con «object queries» aprendibles devuelve de una vez un número fijo de predicciones.
Pipeline simplificado: un backbone (como ResNet) extrae features visuales, el encoder Transformer las procesa globalmente, y el decoder utiliza N queries (típicamente 100) para predecir N potenciales objetos, cada uno con su caja y clase.
DETR elimina la supresión de no máximos (NMS) con el matching húngaro, un algoritmo de asignación bipartita. Durante el entrenamiento empareja cada objeto real con una sola predicción, la de menor coste global. Como cada objeto tiene una única predicción responsable, el modelo aprende a no duplicar y el filtrado final deja de hacer falta.
Predice miles de cajas candidatas y necesita un proceso de filtrado (NMS) para eliminar las duplicadas.
Asigna una predicción única a cada objeto real utilizando un algoritmo de matching húngaro basado en un coste global.
Mueve p1, la predicción más segura, hacia el coche B. Emparejar por orden de confianza le da B y deja a p2 sin pareja útil; la asignación húngara minimiza el coste total.
| Predicción | A | B | C |
|---|---|---|---|
| p1 | 0,80 | 0,67 | 1,00 |
| p2 | 1,00 | 0,14 | 1,00 |
| p3 | 1,00 | 1,00 | 0,14 |
| p4 | 1,00 | 1,00 | 1,00 |
Coste por confianza1,81
Coste húngaro1,08
p1 elige primero y se queda con B, que es el que más solapa. p2 tiene que conformarse con A, al que no toca: el coste total sube a 1,81.
Coste simplificado: solo cuenta el solape. DETR suma además el error de clase y la distancia L1 entre cajas.
Esta página recoge el estado con p1 en x = 36, emparejando por orden de confianza. p1 solapa un 33 % con B y un 20 % con A, así que elige B; p2, que cubría B casi perfectamente, se queda con A y no lo toca. Coste total: 1,81. La asignación húngara prueba el reparto completo y prefiere p1 con A y p2 con B: 1,08. Con p1 por debajo de x = 34 los dos métodos coinciden. DETR usa la húngara durante el entrenamiento; p4, la predicción sobrante, aprende a decir «ningún objeto».
La asignación bipartita ocurre durante el entrenamiento, no en la inferencia.
Respuesta A. Exacto: define qué objetivo supervisa cada predicción.
El coste combina clase y geometría. Al forzar una correspondencia uno a uno, el modelo aprende a no duplicar predicciones y deja de necesitar NMS al inferir.
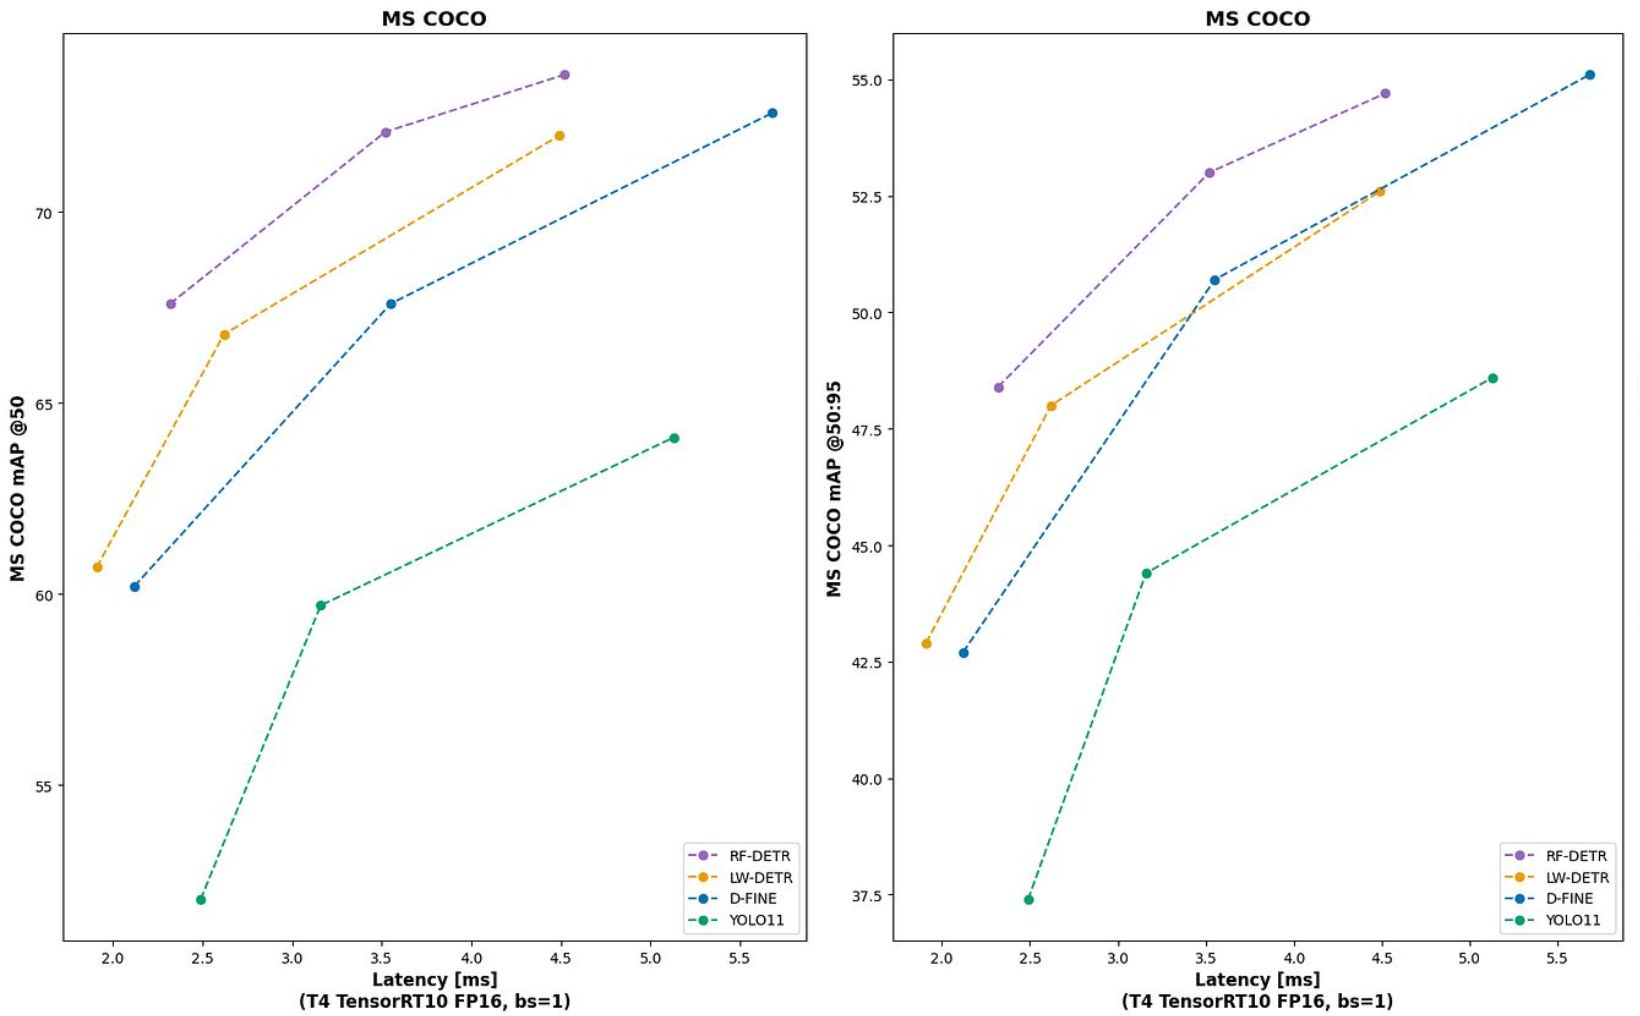
RF-DETR (Roboflow, 2025; publicado en ICLR 2026) es un detector en tiempo real de la familia DETR. Su versión 2XL fue el primer detector en tiempo real en pasar de 60 AP en COCO, y la nano da 48,0 AP, 5,3 más que D-FINE nano con una latencia parecida.
Parte de un vision transformer entrenado sin etiquetas sobre millones de imágenes (tema 4). Por eso se adapta rápido a un dominio nuevo con pocos datos.
En lugar de mirar todos los píxeles, cada query consulta unos pocos puntos de muestreo en cada escala. Así trabaja con mapas de alta resolución sin disparar el coste, lo que ayuda con los objetos pequeños.
Como todo DETR, no necesita anchors predefinidos ni supresión de no máximos. Una búsqueda de arquitectura (NAS) entrena una sola red y saca de ella versiones de nano a 2XL sin reentrenar.
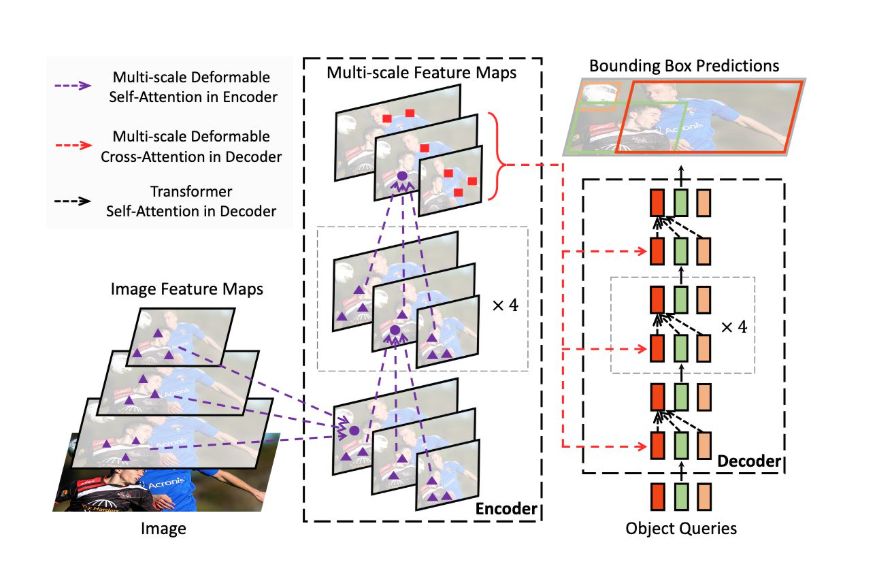
RF-DETR hereda el decoder de Deformable DETR y cambia la primera mitad: donde aquel usaba una CNN y un encoder con atención deformable, RF-DETR pone DINOv2.
Deformable DETR toma mapas de varias resoluciones de una CNN. RF-DETR los saca de la salida de DINOv2, con un proyector que la reescala a varios tamaños.
En Deformable DETR, un encoder con autoatención deformable (morado en la figura). En RF-DETR, el propio DINOv2, que alterna atención por ventanas y atención global para equilibrar precisión y latencia.
Las «object queries» consultan las features de todas las escalas en unos pocos puntos cada una (rojo en la figura). Esta parte es igual en los dos modelos.
Varias capas de decoder refinan las predicciones: cada una parte de las cajas de la anterior y las corrige.
El modelo entrega una caja y una clase por query, sin el posprocesado de NMS.
Ultralytics es muy popular, pero este curso necesita código abierto que se pueda leer por dentro y con licencias que no limiten ni la investigación ni el uso industrial.
Código y pesos van con AGPL-3.0, que obliga a publicar el código de la aplicación que los incorpora cuando la distribuyes, y también cuando solo la ofreces como servicio en red. Para evitarlo hay que pagar su licencia comercial. AGPL es open source, pero choca con la mayoría de usos industriales.
Sus versiones (YOLOv5, YOLOv8, YOLO11 y YOLO26) se presentan como la continuación de YOLO, pero no vienen de Joseph Redmon ni de la línea académica que siguió su trabajo. Como otros grupos numeran también sus YOLO (v6, v7, v9, v10, v12), el número ya no dice de dónde sale cada modelo.
Está pensado para usarse a través de su CLI y de su API de alto nivel. Estudiarlo por dentro o adaptarlo a un proyecto de investigación cuesta bastante más.
Varias versiones salieron sin un paper que describa la arquitectura y los experimentos, lo que dificulta reproducir resultados y explicarlos en clase.
Las condiciones de licencia se revisan por versión y por artefacto: el código y los pesos pueden tener términos distintos y cambiar entre versiones. Conviene comprobar la licencia vigente del repositorio y del checkpoint concreto antes de decidir.
RF-DETR es el detector de referencia del curso: su arquitectura es moderna y legible, y el proyecto es open source con licencia Apache 2.0.
Permite usarlo, modificarlo y venderlo en industria, investigación y enseñanza, sin obligación de publicar tu código.
Es un DETR: backbone, decoder con queries y salida directa, sin anchors ni NMS. Entenderlo es entender cómo se construyen los detectores actuales.
Se lee y se modifica bien, y el mismo paquete sirve para inferir y para reentrenar con tus datos.
A igual latencia en una T4, da más mAP en COCO que YOLO11 según las curvas de su repositorio (siguiente pantalla).
La elección entre RF-DETR y YOLO depende de tus prioridades específicas de producción.
Consideraciones prácticas:
Las curvas proceden del repositorio de RF-DETR y se miden en un hardware concreto. Antes de decidir conviene reproducir la medida en el dispositivo de destino, con el tamaño de entrada, la precisión numérica y el tamaño de lote que se vayan a usar realmente.
Un vídeo normal va a 25 o 30 fotogramas por segundo (FPS). Para seguirlo en directo, todo el trabajo de un fotograma tiene que caber en unos 35 milisegundos.
FPS es 1 entre el tiempo por fotograma. Se mide con un fotograma cada vez, tras unas pasadas de calentamiento y contando todo: leer, preparar la imagen, el modelo, el posproceso y el dibujo.
Exportar el modelo a ONNX y optimizarlo para el hardware: TensorRT en GPU de NVIDIA, OpenVINO en procesadores de Intel. Así están medidas las curvas de la pantalla anterior.
Junto a la cámara, en un NVIDIA Jetson por ejemplo, se usan las versiones pequeñas y la exportación optimizada. La cifra que vale es la medida en ese equipo, no la del portátil.
En el ejercicio de vídeo del cuaderno 1, RF-DETR medium procesa 200 fotogramas de 960 × 540 a unos 25 FPS en una RTX 3080 Ti de portátil, contando el proceso entero; una T4 de Colab va más despacio. Las versiones small y nano son más rápidas y algo menos precisas. Para decidir, se mide en el dispositivo de destino con la resolución, la precisión numérica y el tamaño de lote reales.
La Intersection over Union (IoU) mide cuánto se solapan dos cajas delimitadoras: la que predice el modelo y la caja de verdad (ground truth) anotada a mano. Es lo que decide si una predicción cuenta como acierto (True Positive) o como falsa alarma (False Positive). Va de 0, sin solapamiento, a 1, cajas idénticas.
En la figura, la caja predicha está en rojo y la de verdad en verde. La IoU divide el área donde se superponen entre el área total que cubren las dos juntas.
IoU0,33
Solapamiento parcial.
IoU vale 1 cuando ambas cajas coinciden y 0 cuando no comparten área. Para decidir TP, FP y FN también se tiene en cuenta la clase, la correspondencia uno a uno y un protocolo de evaluación.
Detecciones correctas: cajas predichas que coinciden con objetos reales (IoU > umbral).
Falsas alarmas: cajas predichas donde no hay objeto real o con IoU por debajo del umbral.
Objetos perdidos: objetos reales que el modelo no detectó.
La métrica de True Negatives, común en problemas de clasificación binaria, no aplica de la misma manera en la detección de objetos:
Por esta razón, las métricas en detección de objetos se enfocan únicamente en TP, FP y FN, que son los únicos resultados que se pueden contar.
Saber si el modelo ha detectado algo no basta. La precisión dice cuánto puedes fiarte de lo que detecta; el recall, cuánto de lo que hay consigue encontrar.
Mide la fiabilidad de las detecciones: con alta precisión hay pocos falsos positivos (detectar algo que no está o confundir su clase). Importa cuando una falsa alarma sale cara, como en inspección de calidad o en sistemas de seguridad.
Precisión = TPTP + FP
Responde a: «De todas mis predicciones, ¿cuántas son correctas?».
Mide la capacidad de encontrar todos los objetos: con alto recall hay pocos falsos negativos (objetos presentes que no se detectan). Importa cuando perder uno es grave, como una persona en vigilancia o un tumor en imagen médica.
Recall = TPTP + FN
Responde a: «De todos los objetos reales, ¿cuántos he detectado?».
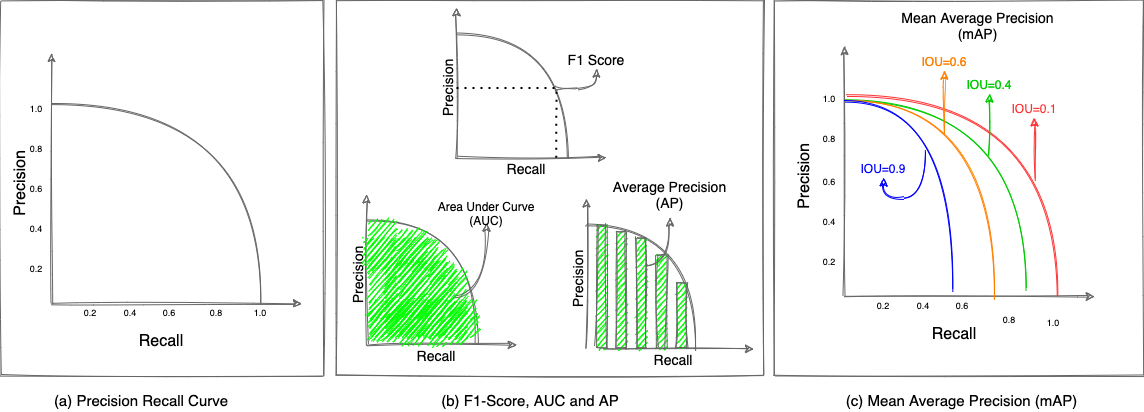
Cómo se leen:
Las dos suelen tirar en direcciones opuestas, un trade-off, aunque la precisión no siempre sube al filtrar. Un modelo que detecta con mucha manga ancha para no perderse nada (recall alto) también da más falsas alarmas (precisión baja). El punto de equilibrio lo decide la aplicación.
Aplica las dos fórmulas a un recuento concreto.
Respuesta C. Exacto: 3/(3+1) y 3/(3+2).
Con 3 TP, 1 FP y 2 FN: precisión = 3 / (3 + 1) = 0,75 y recall = 3 / (3 + 2) = 0,60. La precisión mira el denominador de las predicciones; el recall, el de los objetos reales.
Al filtrar por puntuación el recall solo puede bajar; la precisión suele subir, aunque no siempre.
Precisión0,75
Recall1,00
TP 3 FP 1 FN 0
Se ven todos los objetos, pero también sobran predicciones.
Esta página recoge el estado con umbral 0,30. El emparejamiento sigue el protocolo habitual: las predicciones se ordenan por puntuación y cada una reclama el objeto libre con el que comparte más área, siempre que el IoU llegue a 0,50. La predicción de 0,24 solapa con el tercer objeto, pero llega tarde: ese objeto ya está emparejado, así que cuenta como falso positivo duplicado. Al subir el umbral desaparecen antes las predicciones dudosas: sube la precisión y baja el recall. La curva precisión-recall recorre ese intercambio umbral a umbral.
El umbral de confianza decide qué predicciones se muestran; IoU evalúa su solapamiento.
Respuesta A. Exacto: el filtro elimina las puntuaciones que quedan por debajo del nuevo umbral.
Al subir el umbral suelen desaparecer predicciones de baja puntuación: pueden bajar los falsos positivos y también aumentar los falsos negativos. La curva precisión-recall estudia ese intercambio recorriendo muchos umbrales.
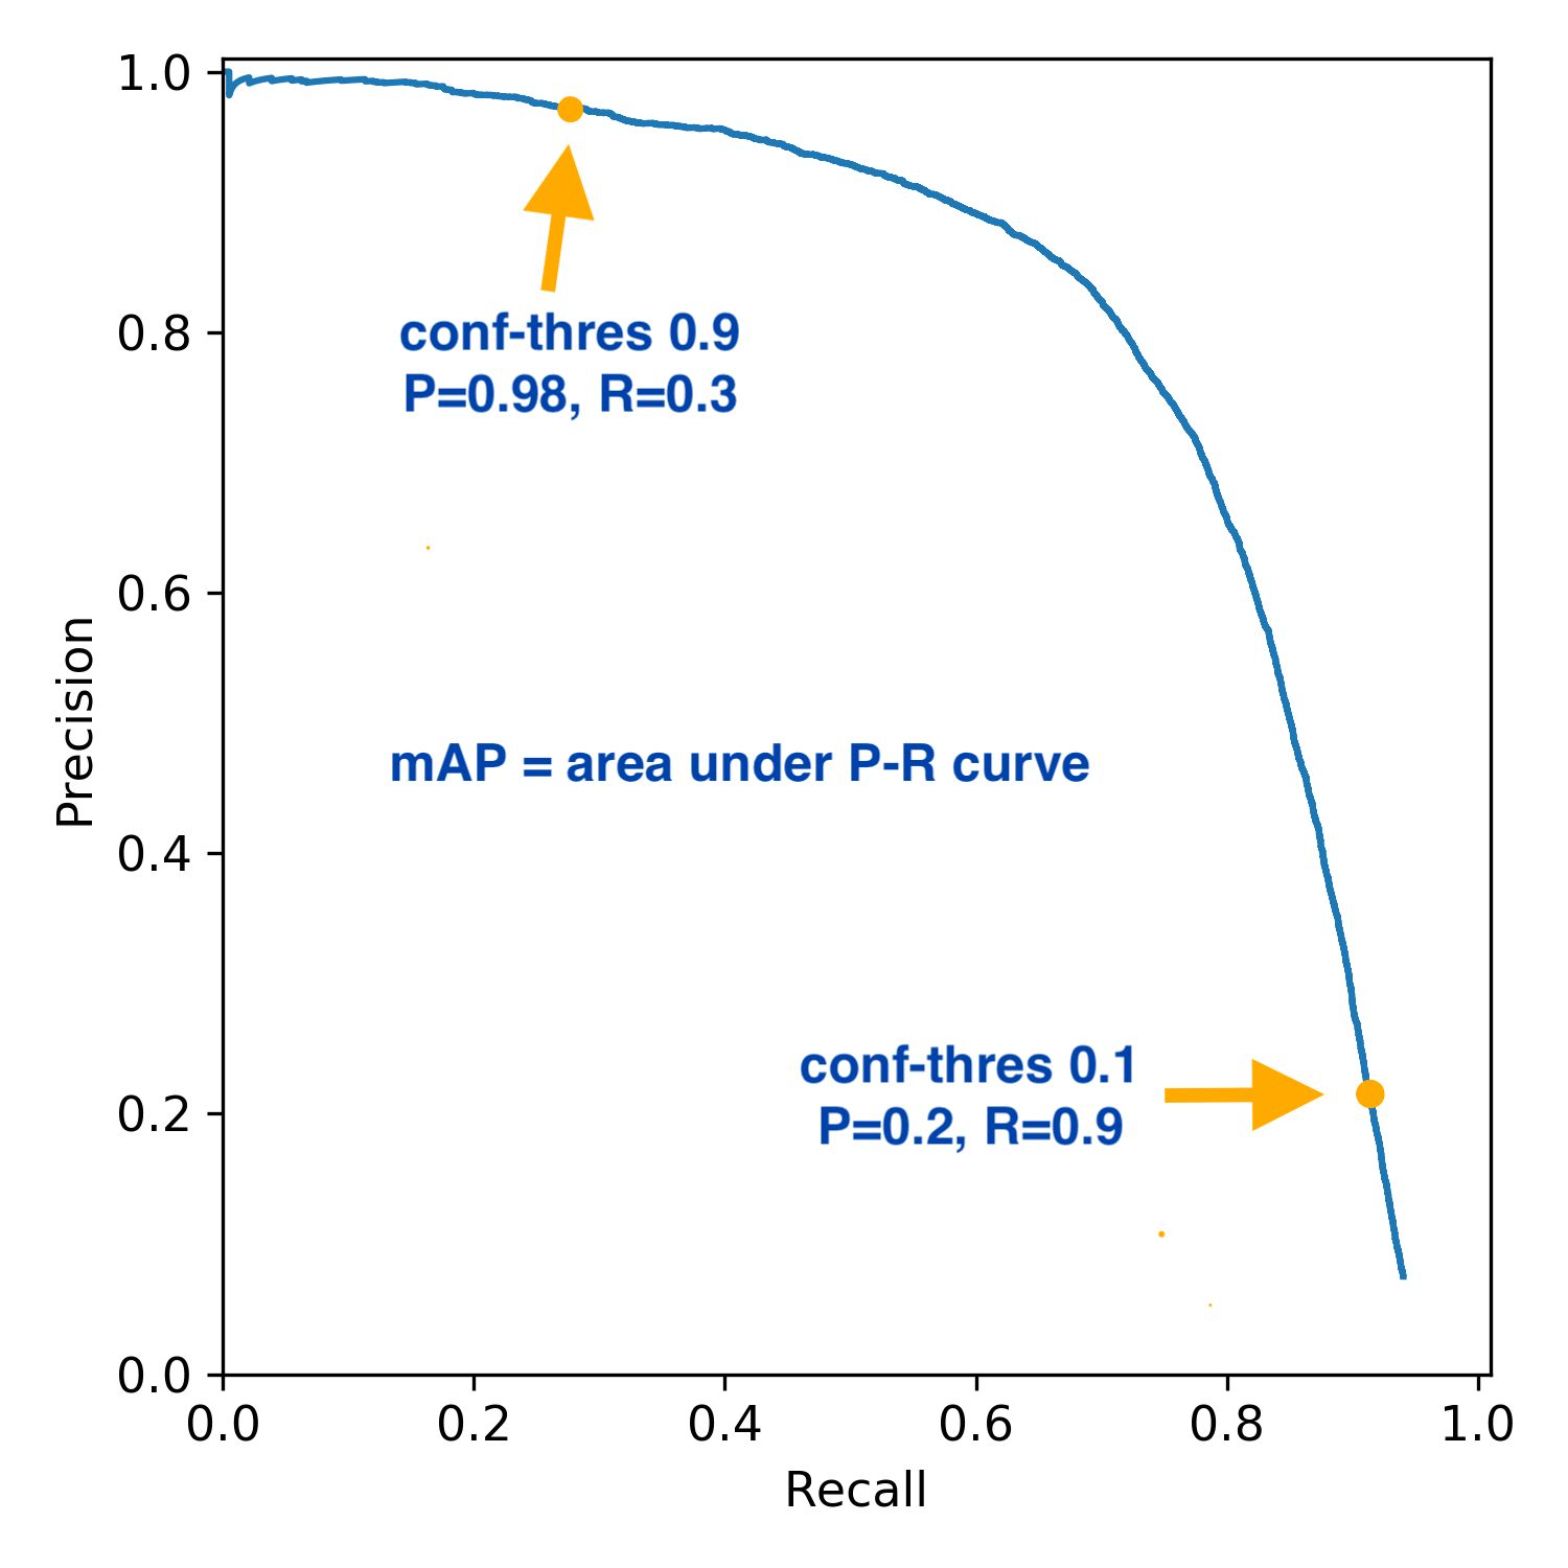
AP (Average Precision): es el área bajo la curva precisión-recall. Resume en un número lo bien que el modelo encuentra los objetos (recall alto) sin llenarse de falsos positivos (precisión alta). Cuanto más alta, mejor.
mAP (mean Average Precision): la métrica estándar para comparar detectores. Es la media de la AP de todas las clases del conjunto de evaluación. mAP@0.5 la calcula con IoU 0,5; mAP@[0.5:0.95], la métrica principal de COCO, la promedia además entre diez umbrales de 0,50 a 0,95.
Recorrer el umbral de confianza traza la curva: con umbral 0,9 la precisión es alta y el recall bajo; con 0,1 ocurre lo contrario. AP50 y AP promediada entre varios umbrales de IoU responden a protocolos distintos y no son intercambiables.
Ocho detecciones de una clase, ordenadas por confianza, para seis objetos reales. Cada vez que el umbral deja pasar una más, la curva gana un punto; la AP es el área bajo su escalera.
Precisión0,75
Recall0,50
Área acumulada 0,47AP final 0,70
Con umbral 0,76 entra un acierto: el recall sube a 0,50 y la precisión queda en 0,75.
Esta página recoge el estado con umbral 0,76: cuatro detecciones aceptadas, tres aciertos y un falso positivo, con precisión 0,75 y recall 0,50. Cada falso positivo baja la precisión sin mover el recall; cada acierto sube el recall. Para calcular el área, cada punto toma la mejor precisión que se alcanza a ese recall o a uno mayor, y por eso la curva sombreada es una escalera. Con las ocho detecciones el recall se queda en 0,83 porque un objeto no lo encontró ninguna, y la AP vale 0,70. COCO usa 101 puntos de recall en vez de todos, con el mismo principio.
El dataset COCO, con sus 80 clases estándar (persona, coche, perro, silla…), es excelente para benchmarking pero normalmente no cubre las necesidades reales de industria o dominios especializados.
Problema del dominio: una fábrica necesita detectar «tornillo oxidado», «conector suelto», «clip roto» o «soldadura defectuosa». Estos objetos específicos no existen en COCO.
Coste de adaptación: reanotar miles de imágenes para nuevas categorías es caro y lento. Entrenar desde cero o fine-tunear requiere tiempo de GPU, experimentación y validación.
Esta limitación motiva la necesidad de métodos más flexibles: detectores guiados por texto (zero-shot), modelos fundacionales multimodales, y técnicas que puedan adaptarse rápidamente a nuevos dominios sin anotación exhaustiva.
Un checkpoint aprende las clases de sus datos. Tu aplicación puede necesitar otras.
Respuesta B. Exacto: la nueva categoría exige una estrategia y una evaluación en el dominio.
Un detector de vocabulario cerrado solo puede nombrar las categorías con las que fue entrenado. Ampliarlo exige anotar y reentrenar, o cambiar a un enfoque guiado por texto.
Evaluar un detector va más allá de mirar su mAP en COCO. Para desplegarlo de verdad hay que:
1. Medir en tu dominio específico: crea un conjunto de validación representativo de tus datos reales. Un modelo con 60 % mAP en COCO puede tener 40 % o 80 % en tu caso de uso particular.
2. Equilibrar velocidad y precisión: un detector con 2 % más de AP pero un 50 % más lento puede no compensar si necesitas procesar 30 FPS. Mide la latencia de extremo a extremo, no la cifra teórica del paper.
3. Analizar errores cualitativamente: inspecciona visualmente los casos de:
Los patrones de error te dirán si necesitas más datos, data augmentation específico, o cambiar de arquitectura.
Un benchmark no sustituye datos representativos, latencia medida y análisis de errores.
Respuesta C. Exacto: la elección depende del problema, del entorno y de los errores que aceptas.
Un AP mejor en un benchmark público indica rendimiento sobre ese conjunto y ese protocolo. La decisión necesita además datos de tu dominio, latencia medida en el hardware de destino y revisión de los errores que importan.
Los detectores de este tema comparten tres límites. Los modelos multimodales del tema 3 atacan los tres.
Lo mínimo que necesitas para tener cajas sobre una imagen tuya.
from transformers import pipeline
from PIL import Image
detector = pipeline("object-detection", model="Roboflow/rf-detr-medium")
image = Image.open("mi_imagen.jpg").convert("RGB")
for d in detector(image, threshold=0.5):
print(d["label"], round(d["score"], 2), d["box"])
xmin e ymin para la esquina superior izquierda, xmax e ymax para la inferior derecha.transformers ya viene incluido.RF-DETR se publica bajo Apache 2.0 y devuelve las clases de COCO. Para un vocabulario propio hace falta fine-tuning con un dataset anotado, cuyo coste estima la calculadora de presupuesto, tres pantallas más adelante.
La receta anterior baja un modelo ya entrenado antes de detectar nada. Ese paso silencioso es el tema siguiente.
Es lo que acabas de ejecutar. RF-DETR está publicado como Roboflow/rf-detr-medium con licencia Apache 2.0, y pipeline lo descarga y lo usa como a cualquier otro modelo del curso. Por dentro hace los dos pasos de abajo.
La otra vía es rfdetr, que trae el modelo, su propio predict y su entrenamiento. No viene en Colab: se instala con pip install rfdetr.
from transformers import AutoImageProcessor, RfDetrForObjectDetection
processor = AutoImageProcessor.from_pretrained("Roboflow/rf-detr-medium")
model = RfDetrForObjectDetection.from_pretrained("Roboflow/rf-detr-medium")
Ese identificador de dos partes, quién publica y qué publica, es la unidad con la que se trabaja a partir de aquí. El tema 2 va de leer lo que hay detrás: qué licencia trae, cuánta memoria pide y cómo elegir entre los cientos que dicen hacer lo mismo.
Las dos vías cargan los mismos pesos y se diferencian en el envoltorio. transformers expone la interfaz común de la librería, que es la que comparten todos los modelos de los temas siguientes y la que permite intercambiar un detector por otro sin reescribir el resto; por eso es la que usa el cuaderno, también para el ajuste fino. El paquete rfdetr expone la API de Roboflow, con predict y un entrenamiento propio. El identificador y el nombre de clase están tomados de la ficha del modelo, consultada el 17 de septiembre de 2026. El curso pasado RF-DETR solo se podía usar por el paquete; la integración en transformers es reciente.
El paquete de Roboflow, rfdetr, trae además segmentación y puntos clave. Cambia la clase y cambia lo que recibes, con la misma foto y las mismas tres líneas. No viene en Colab: antes hay que ejecutar pip install rfdetr.
from rfdetr import RFDETRMedium
modelo = RFDETRMedium()
salida = modelo.predict("foto.jpg", threshold=0.5)
print(salida.xyxy) # una caja por objeto
print(salida.class_id) # su clase de COCO
from rfdetr import RFDETRSegPreview
modelo = RFDETRSegPreview()
salida = modelo.predict("foto.jpg", threshold=0.5)
print(salida.mask.shape) # una máscara por objeto
print(salida.mask[0].sum()) # área del primero, en píxeles
import cv2
from rfdetr import RFDETRKeypointPreview
modelo = RFDETRKeypointPreview()
imagen = cv2.cvtColor(cv2.imread("foto.jpg"), cv2.COLOR_BGR2RGB)
puntos = modelo.predict(imagen, threshold=0.5)
print(puntos.xy.shape) # personas x 17 puntos x 2
print(puntos.keypoint_confidence[0]) # confianza de cada punto
Una caja por objeto, en píxeles. Sirve para contar, para disparar un aviso y para recortar la zona antes de mirarla con más detalle.
Haz una foto a tu mesa, con una persona dentro si puedes, y pasa las tres. Luego responde con cada salida a la misma pregunta: ¿cuánto ocupa ese objeto? La caja da un rectángulo, la máscara da los píxeles de verdad y el esqueleto no responde, porque mide otra cosa.
Las tres salidas son objetos de supervision, así que se dibujan con sv.BoxAnnotator, sv.MaskAnnotator y sv.EdgeAnnotator sin tocar nada más.
Las tres tareas comparten el backbone DINOv2 y solo cambia la cabeza que va encima. Es la idea de modelo fundacional que recorre el curso, en tres líneas de código.
Segmentación y puntos clave se publican como «preview», es decir, acceso temprano pensado sobre todo para ajustar el modelo con un dataset propio; las clases son RFDETRSegPreview y RFDETRKeypointPreview, y la licencia del paquete abierto es Apache 2.0. Los puntos clave son los 17 de COCO, los mismos que se evalúan con OKS en el tema 6. Las variantes de detección aparecen en el tema 1, la segmentación es lo que se estudia en el tema 5 con SAM y la pose, en el tema 6: esta pantalla adelanta que el mismo paquete cubre las tres, con la diferencia de que aquí las clases son las de COCO y con SAM se segmenta cualquier cosa sin lista de clases. Consultado el 17 de septiembre de 2026 en la documentación de Roboflow.
La cuenta que decide si fine-tuneas o te apoyas primero en un detector guiado por texto.
Imágenes que anotar1200
Horas, con revisión incluida20
Jornadas de una persona3,3
Coste asumible para un conjunto propio. Aun así, empieza validando con zero-shot para saber si hace falta.
Estimación de orden de magnitud. Suma un 30 % de revisión sobre el tiempo de anotación y cuenta 6 horas productivas por jornada.
La página recoge el caso de 4 clases, 300 imágenes por clase y 45 segundos por imagen. Las cifras que más se disparan son las clases y los segundos por imagen: anotar segmentación o puntos clave multiplica el tiempo respecto a poner cajas. Antes de asumir ese coste conviene comprobar cuánto resuelve un detector guiado por texto sin anotar nada, que se ve en el tema 3.
El umbral no se elige en abstracto: depende de qué duele más en tu aplicación.
No detectar a alguien que sí está es el fallo grave. Una falsa alarma cuesta una comprobación; un objeto perdido cuesta el incidente.
Qué hacer: baja el umbral de confianza y asume más falsos positivos. Añade una segunda comprobación, humana o automática, para filtrarlos.
Dejar pasar una pieza defectuosa llega al cliente; marcar una buena solo cuesta una revisión en planta.
Qué hacer: umbral bajo y una estación de revisión. Mide cuántas piezas buenas estás parando, porque ese es el coste que notará producción.
Contar de más es peor que contar de menos: dispara reposiciones y pedidos equivocados que nadie revisa.
Qué hacer: sube el umbral hasta que apenas haya duplicados y vigila el recuento frente a un conteo manual de control.
Aquí no importa cada persona concreta sino que el sesgo sea estable. Un error constante se corrige; uno que cambia con la hora o el clima, no.
Qué hacer: deja el umbral intermedio y valida sobre grabaciones de momentos distintos, no sobre una sola.
La regla general: si el coste de perder un objeto supera al de revisar una falsa alarma, baja el umbral; si es al revés, súbelo. Y en todos los casos, mide el efecto sobre tus propios datos, no sobre el benchmark.
Ocho comprobaciones que evitan casi todos los sustos.
Prueba RF-DETR en tu copia del cuaderno.
Un detector cerrado reconoce sus clases; el tema 3 añade lenguaje y zero-shot.
Abrir en Colab ↗En Colab: Archivo → Guardar una copia en Drive. Empieza por inferencia. La disponibilidad de GPU varía. El ajuste fino descarga solo su dataset desde el Hub (CPPE-5, equipos de protección sanitaria), congela DINOv2 y entrena el resto en menos de 10 minutos en una GPU T4; no hay que instalar nada. La comparación entre 0,25, 0,50 y 0,75 permite observar qué predicciones desaparecen sin confundir confianza con IoU. El tema 3 amplía el vocabulario cerrado con modelos que relacionan visión y lenguaje; antes, el tema 2 enseña de dónde salen los pesos.