Seis tareas más, cada una con su modelo fundacional.
Identificar y localizar puntos clave del cuerpo humano o de objetos en imágenes y vídeos.
Extraer texto de imágenes y documentos, transformándolo en datos editables y buscables.
Mejorar la calidad y resolución de imágenes o vídeos, a menudo a partir de datos de baja resolución.
Segmentar y eliminar automáticamente el fondo de una imagen, aislando el objeto principal.
Calcular la distancia de los objetos en una escena respecto a la cámara, creando mapas de profundidad.
Encontrar correspondencias o similitudes entre dos o más imágenes para tareas como la localización o el reconocimiento.
Estructurando el cuerpo humano en coordenadas digitales.
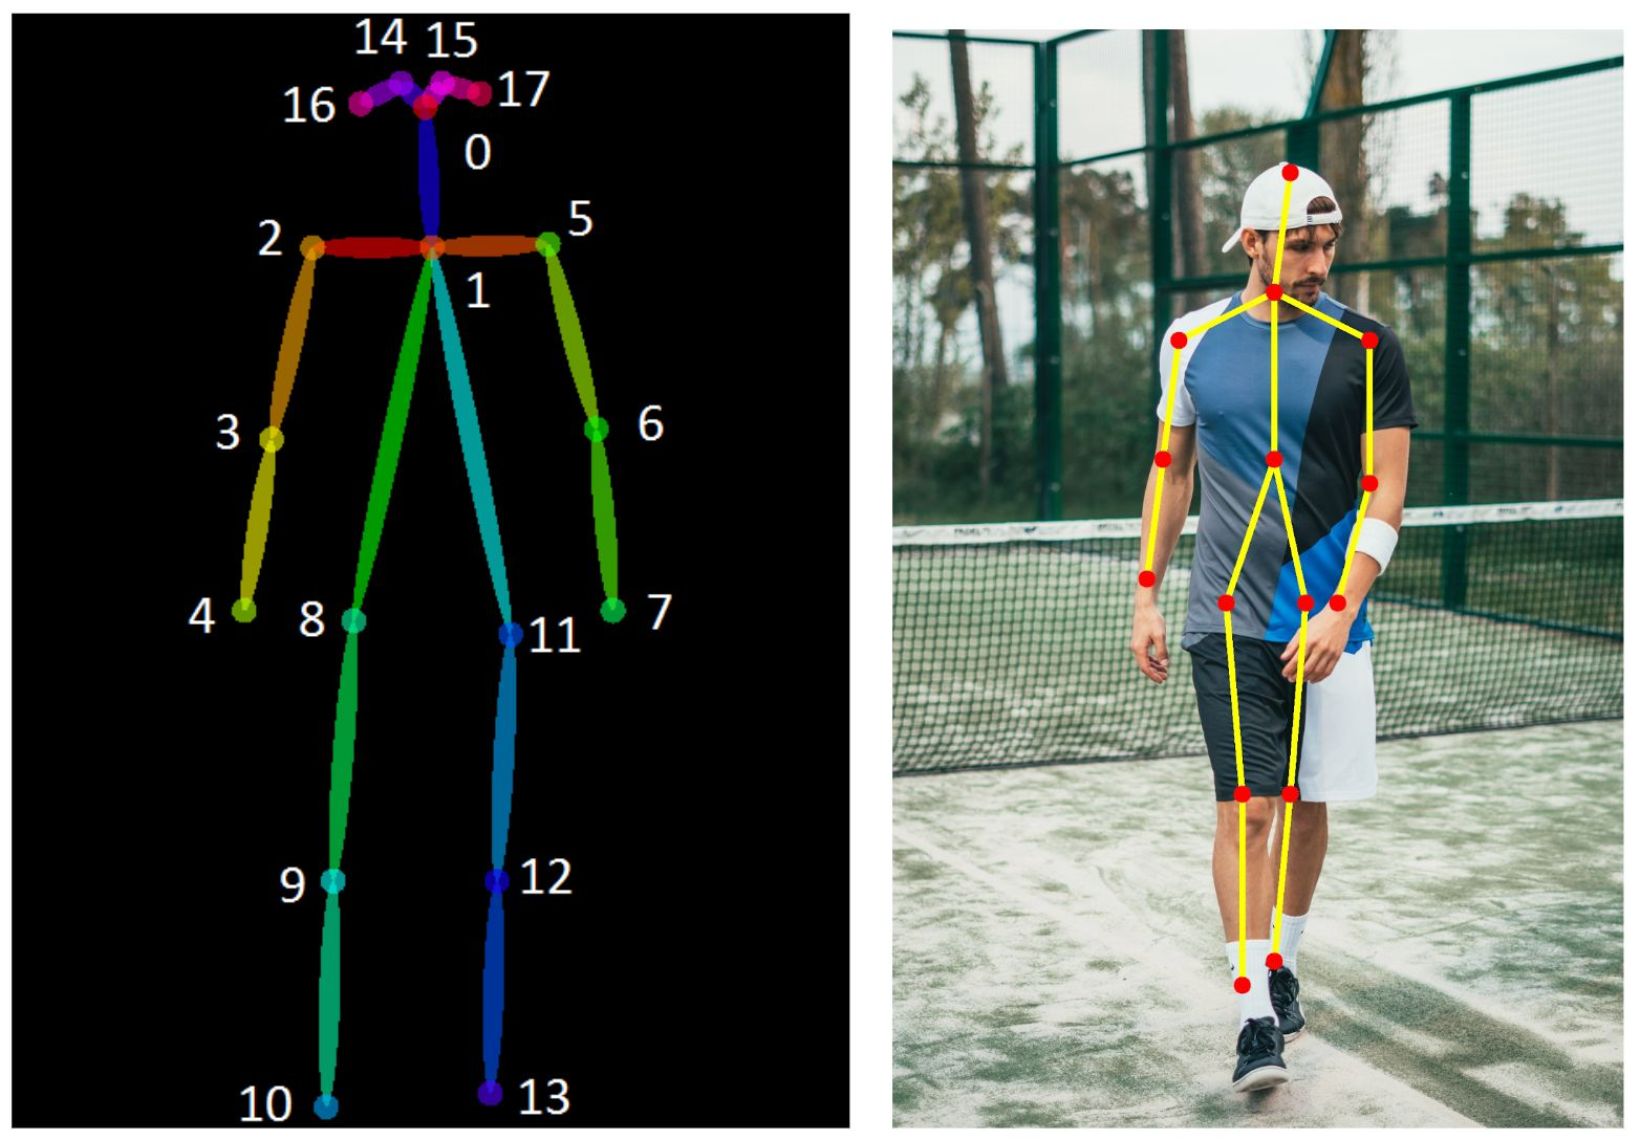
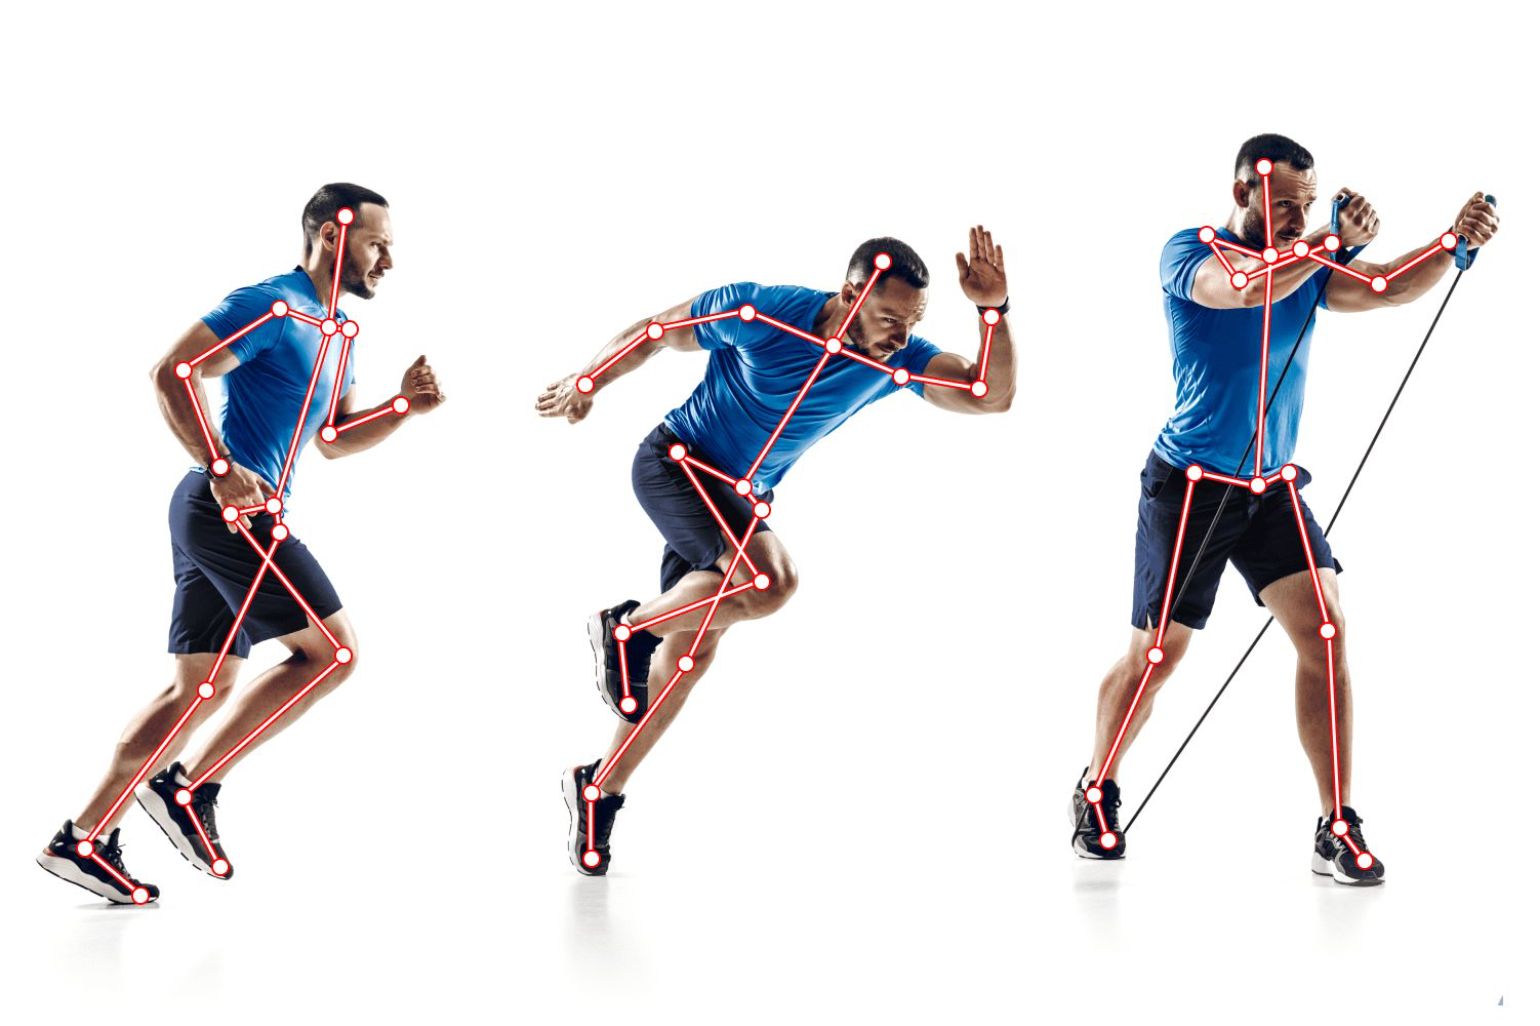
¿Qué es? Tarea de visión que localiza articulaciones clave (keypoints) para modelar la postura y el movimiento.
El estándar (COCO-17): se buscan típicamente 17 puntos.
El output: una lista de coordenadas (x, y) más un score de confianza por punto.
Transformamos una matriz de píxeles ininteligible en una estructura geométrica analizable (skeleton).
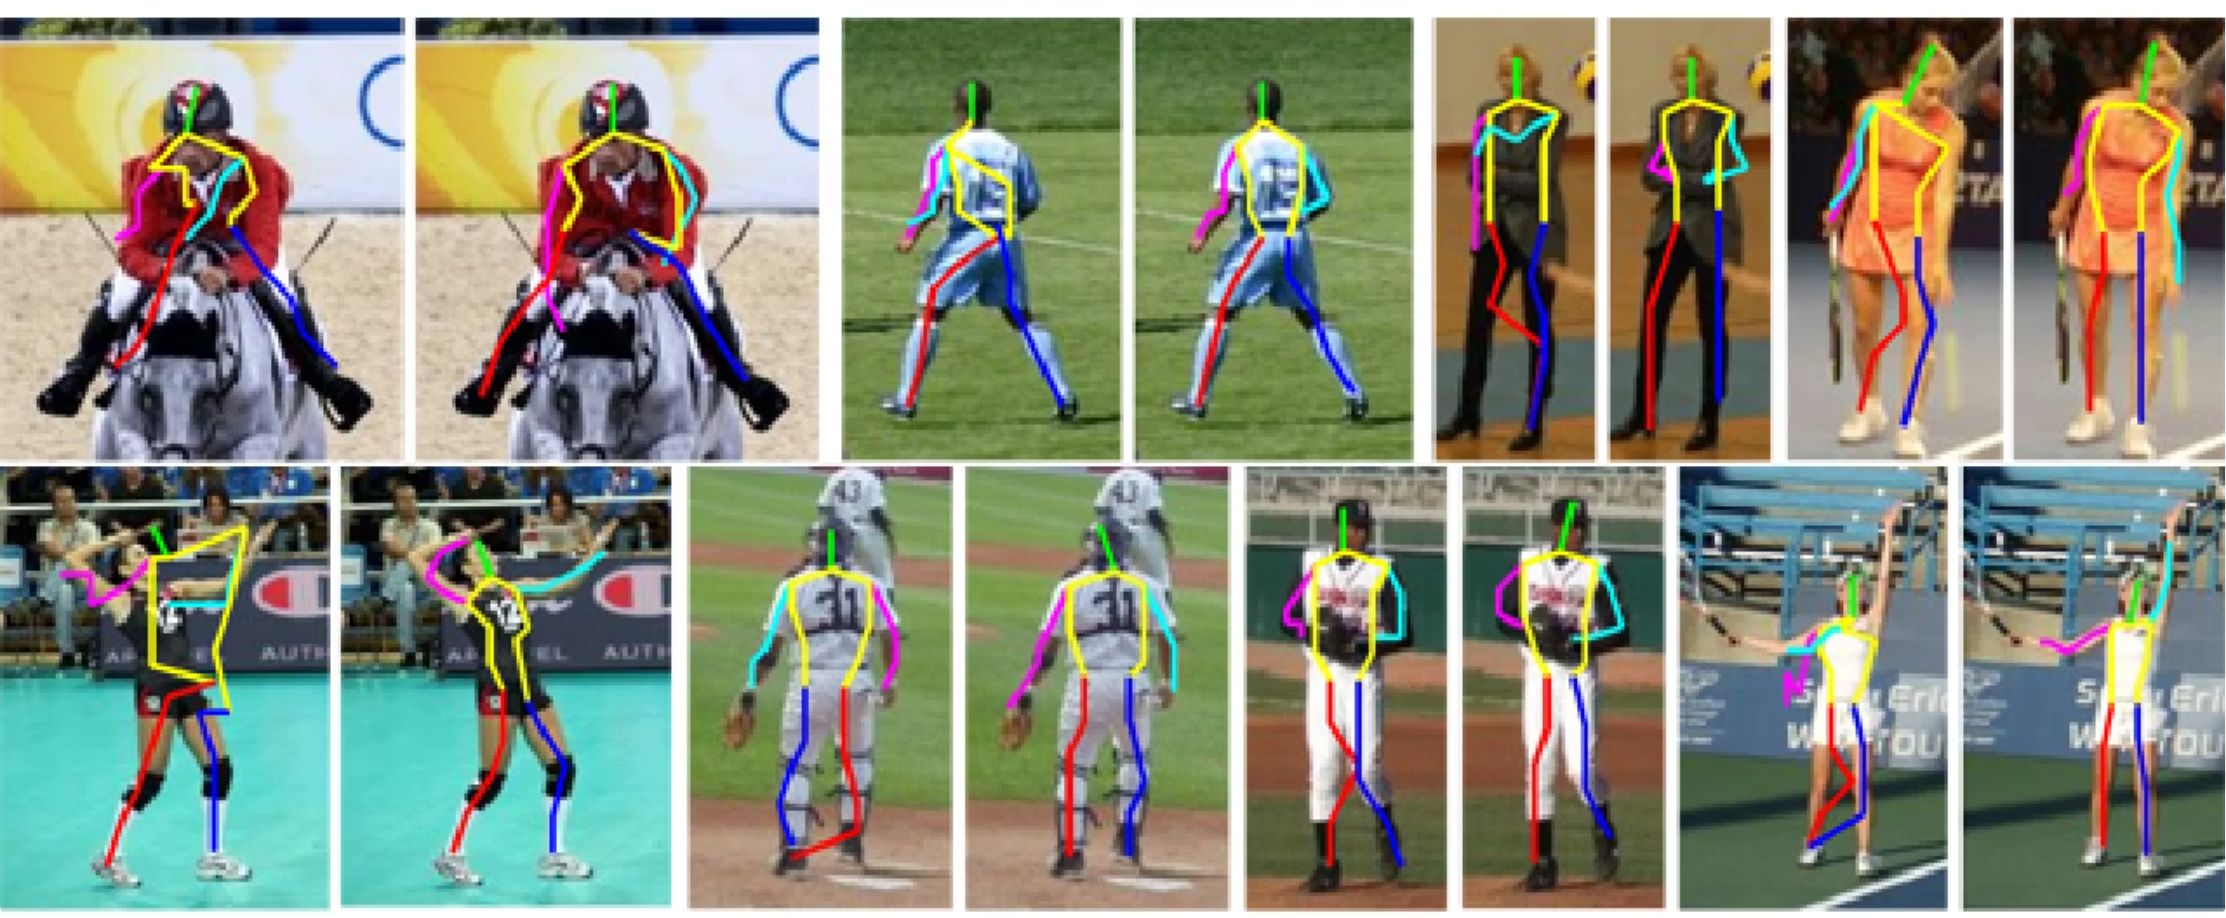
Trade-off entre precisión y velocidad en multitudes.
Proceso: primero detecta personas (cajas), luego estima la pose dentro de cada una.
Ejemplos: HRNet, ViTPose.
Proceso: detecta todos los puntos clave de la imagen a la vez, luego los agrupa en personas.
Ejemplo: OpenPose.
Proceso: redes como YOLO-Pose predicen cajas y puntos simultáneamente en una sola pasada (end-to-end).
Herramientas prácticas para cada escenario.
Funciona bien en CPU y en el móvil. Pensado para fitness, filtros AR y escenas con una o pocas personas cerca de la cámara. Tiene también modelos para manos y cara.
YOLOv8, YOLO11 y YOLO26 en versión pose: varias personas en una pasada, buen equilibrio entre velocidad y precisión y fáciles de reentrenar. Licencia AGPL-3.0, como el resto de Ultralytics (tema 1).
El pionero académico que estableció las bases. Aunque influyente, hoy en día es computacionalmente pesado en comparación con opciones más modernas.
Prioridad en precisión extrema. Cuando la exactitud es crítica (análisis médico, biomecánico) y la velocidad de inferencia es secundaria.
Top-down sobre un ViT sencillo: en el cuaderno, RT-DETR encuentra a las personas y ViTPose les pone los 17 puntos. Licencia Apache 2.0.
OKS (Object Keypoint Similarity) hace con los esqueletos lo que IoU hace con las cajas: convierte la distancia entre cada punto predicho y el real en una puntuación de 0 a 1, corregida por el tamaño de la persona y por lo difícil que es marcar esa articulación.
Por eso el mismo error no penaliza igual: 5 píxeles de error en el ojo, que los anotadores marcan con mucha precisión, cuestan bastante más que 5 píxeles en la cadera, cuya posición exacta es más difícil de fijar.
La tolerancia depende de la articulación y de la escala de la persona (la raíz de su área). Mueve las dos cosas y mira cuándo la pose deja de contar como acierto.
El muñeco mide siempre lo mismo y representa a la persona entera: si la persona encoge, el mismo error en píxeles se ve mayor sobre ella. Las tolerancias son las constantes de COCO.
Cuenta como acierto
OKS del esqueleto0,92
Umbral de acierto0,50
Con escala de 150 px, 5 px dejan el ojo en 0,80 y la cadera en 0,99. El ojo pierde medio punto a partir de 9 px.
Esto explica el fallo más habitual en planta: el modelo va bien con la persona cerca y se desmorona con la persona al fondo, aunque el error en píxeles sea el mismo. Las dos salidas son acercar la cámara o trabajar en top-down, detectando primero a cada persona y recortándola para que llegue grande al modelo de pose.
Esta página recoge el estado con 5 px de error y escala de 150 px. La escala de COCO es la raíz del área de la persona, y el OKS de la pantalla promedia solo tres articulaciones para que se vea el efecto. OKS aplica a cada punto exp(−d² / (2 s² k²)), donde d es el error en píxeles, s la escala de la persona y k = 2σ una constante propia de cada articulación medida sobre anotaciones humanas. Los ojos tienen σ = 0,025 y la cadera σ = 0,107, así que la cadera tolera más de cuatro veces el error antes de penalizar lo mismo. La escala entra dividiendo, de modo que la tolerancia en píxeles es proporcional al tamaño de la persona: en una persona de 60 px el ojo pierde medio punto a partir de 4 px, y en una de 400 px aguanta hasta 24 px. El OKS del esqueleto es la media de los puntos visibles, y sustituye al IoU cuando se calcula AP para pose: COCO promedia AP con umbrales de 0,50 a 0,95, así que el 0,50 de esta pantalla es el criterio más indulgente de los diez.
La tolerancia de cada articulación sale de cómo de acuerdo se ponen los anotadores humanos.
Respuesta B. Exacto: normaliza por tamaño y usa una tolerancia específica por keypoint.
Las constantes por articulación se estimaron midiendo la dispersión entre anotadores. Donde las personas coinciden mucho, como los ojos, el modelo tiene menos margen.
Dónde genera valor la estimación de pose.
El problema: la estimación de pose se complica cuando partes del cuerpo se ocultan entre sí o tras otros objetos, y se pierde información.
La solución: modelos avanzados emplean memoria temporal para rastrear y predecir oclusiones, o realizan inferencia 3D para «imaginar» las partes ocultas basándose en la anatomía y el contexto.
La evolución de Tesseract a los transformers (TrOCR).
Metodología: hasta la versión 3 segmentaba caracteres con reglas y contornos; desde la 4 (2018) reconoce líneas con una red LSTM, pero sigue necesitando texto limpio y horizontal.
Limitaciones comunes:
Arquitectura end-to-end: utiliza Vision Transformers (ViT) para codificar la imagen de forma global y un decoder de texto (en TrOCR, inicializado desde RoBERTa) genera la secuencia de caracteres.
Lo que cambia: lee la línea entera de una vez, con el contexto de las letras vecinas, en lugar de reconocer caracteres sueltos.
Estado del arte (SOTA):
Implementación rápida con Hugging Face y EasyOCR.
Una opción todo terreno para cualquier proyecto. Es ligera, soporta más de 80 idiomas y funciona eficientemente en CPU. Ideal para prototipos rápidos y escenarios donde no se dispone de GPU.
Muy preciso en texto impreso y en manuscrito, según la variante. Lee una sola línea ya recortada, así que necesita un detector de texto delante. Va mucho mejor con GPU.
Perfectos para casos de uso complejos como el procesamiento de facturas o tablas. Permiten extraer información estructurada, por ejemplo JSON, en lugar de solo texto plano, integrando visión y lenguaje para un razonamiento avanzado.
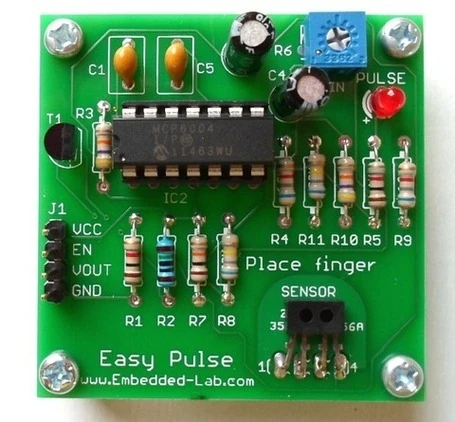
La misma foto de una placa, leída de tres formas. Cambia la herramienta y mira qué recibe tu programa.
Qué herramienta usas
C1 C5 R6 C4 PULSE
T1 R3 MCP6004
IC2 R4 R11 R10 R5 R9
J1 VCC EN VOUT GND
R1 R2 R7 R8
Place finger SENSOR
Easy Pulse
www.Embedded-Lab.com
texto posición tamaño
PULSE (357, 70) 44 x 13
MCP6004 (163, 122) 47 x 16
IC2 (161, 189) 36 x 18
VCC ( 71, 221) 36 x 19
GND ( 71, 283) 38 x 19
R1 (126, 317) 25 x 16
Place finger (250, 252) 120 x 26
SENSOR (282, 281) 55 x 19
Easy Pulse (103, 344) 135 x 34
www.Embedded-Lab.com ( 82, 378) 175 x 23
{
"placa": "Easy Pulse",
"fabricante": "www.Embedded-Lab.com",
"integrado": "MCP6004",
"conector": {
"referencia": "J1",
"pines": ["VCC", "EN", "VOUT", "GND"]
},
"sensor": {
"etiqueta": "SENSOR",
"instruccion": "Place finger"
},
"resistencias": ["R1", "R2", "R4", "R5", "R7", "R8", "R9", "R10", "R11"]
}
Sale una tira de caracteres y poco más. El orden lo inventa el recorrido por líneas, así que «VCC EN VOUT GND» y las referencias de las resistencias se mezclan sin que puedas saber qué va con qué.
La pregunta útil es qué necesita tu programa, más que qué herramienta lee mejor. Para contar si la serigrafía está impresa basta la primera; para comprobar que cada referencia está junto a su componente hacen falta coordenadas; para rellenar un parte de recepción con el modelo y el fabricante, el tercero te ahorra el pegamento.
Las cajas de esta pantalla están medidas a mano sobre la foto para ilustrar el formato de salida, no las ha producido un OCR. Tres cosas que se ven en esta imagen y que aparecen en cualquier planta: el texto de la serigrafía es de bajo contraste sobre verde y el brillo del cobre lo rompe, hay texto a distintas escalas en la misma foto, y varias referencias quedan parcialmente tapadas por los componentes. Por eso la resolución de captura manda más que el modelo: con menos de veinte píxeles de altura por carácter, ningún OCR actual lee de forma fiable. Sobre latencia y coste, Tesseract corre en CPU en decenas de milisegundos, un modelo de detección más reconocimiento ronda las décimas de segundo en GPU, y un VLM se va a varios segundos por imagen, así que en línea suele combinarse: detección rápida siempre y VLM solo sobre las piezas dudosas.
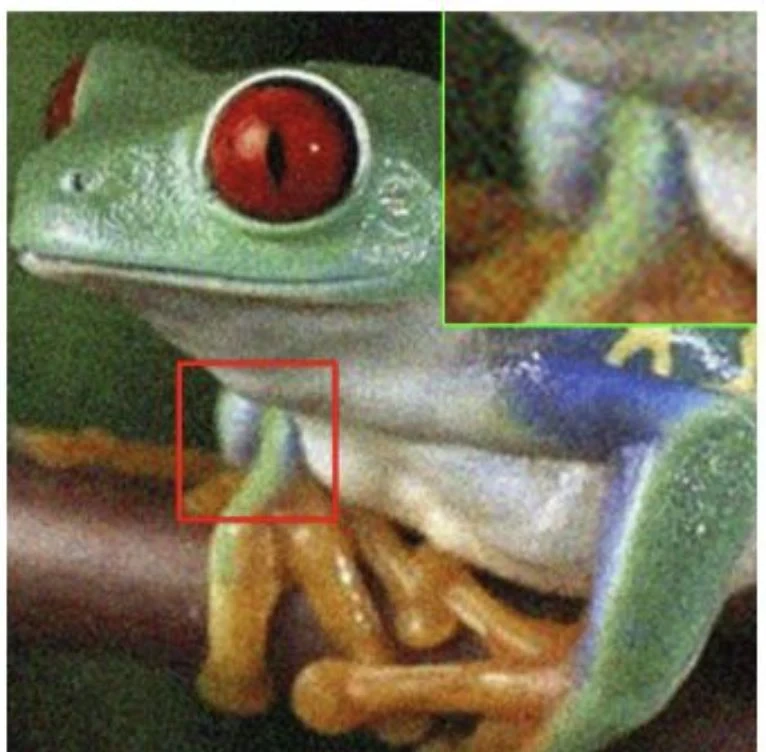
El uso de deep learning para generar detalles plausibles de alta frecuencia a partir de una imagen de baja resolución, superando los límites de la interpolación tradicional (bilineal, bicúbica…).
El modelo del cuaderno: Swin2SR (2022).
Nota importante: la superresolución no es magia. El modelo «imagina» detalles a partir de los patrones que vio al entrenar; no reconstruye información que nunca existió.
Dónde aplicar superresolución en industria.
Riesgo crítico: «alucinaciones». El modelo puede inventar un tumor o una mancha. Nunca usar para diagnóstico crítico sin supervisión.
Lo que aparece al ampliar puede venir del modelo, no del sensor.
Respuesta B. Exacto: la mejora visual no convierte el detalle generado en evidencia.
La superresolución sintetiza textura plausible a partir de patrones aprendidos. En un contexto diagnóstico, cualquier estructura nueva debe comprobarse sobre la imagen original.
El reto del «alpha matting» y el modelo RMBG.
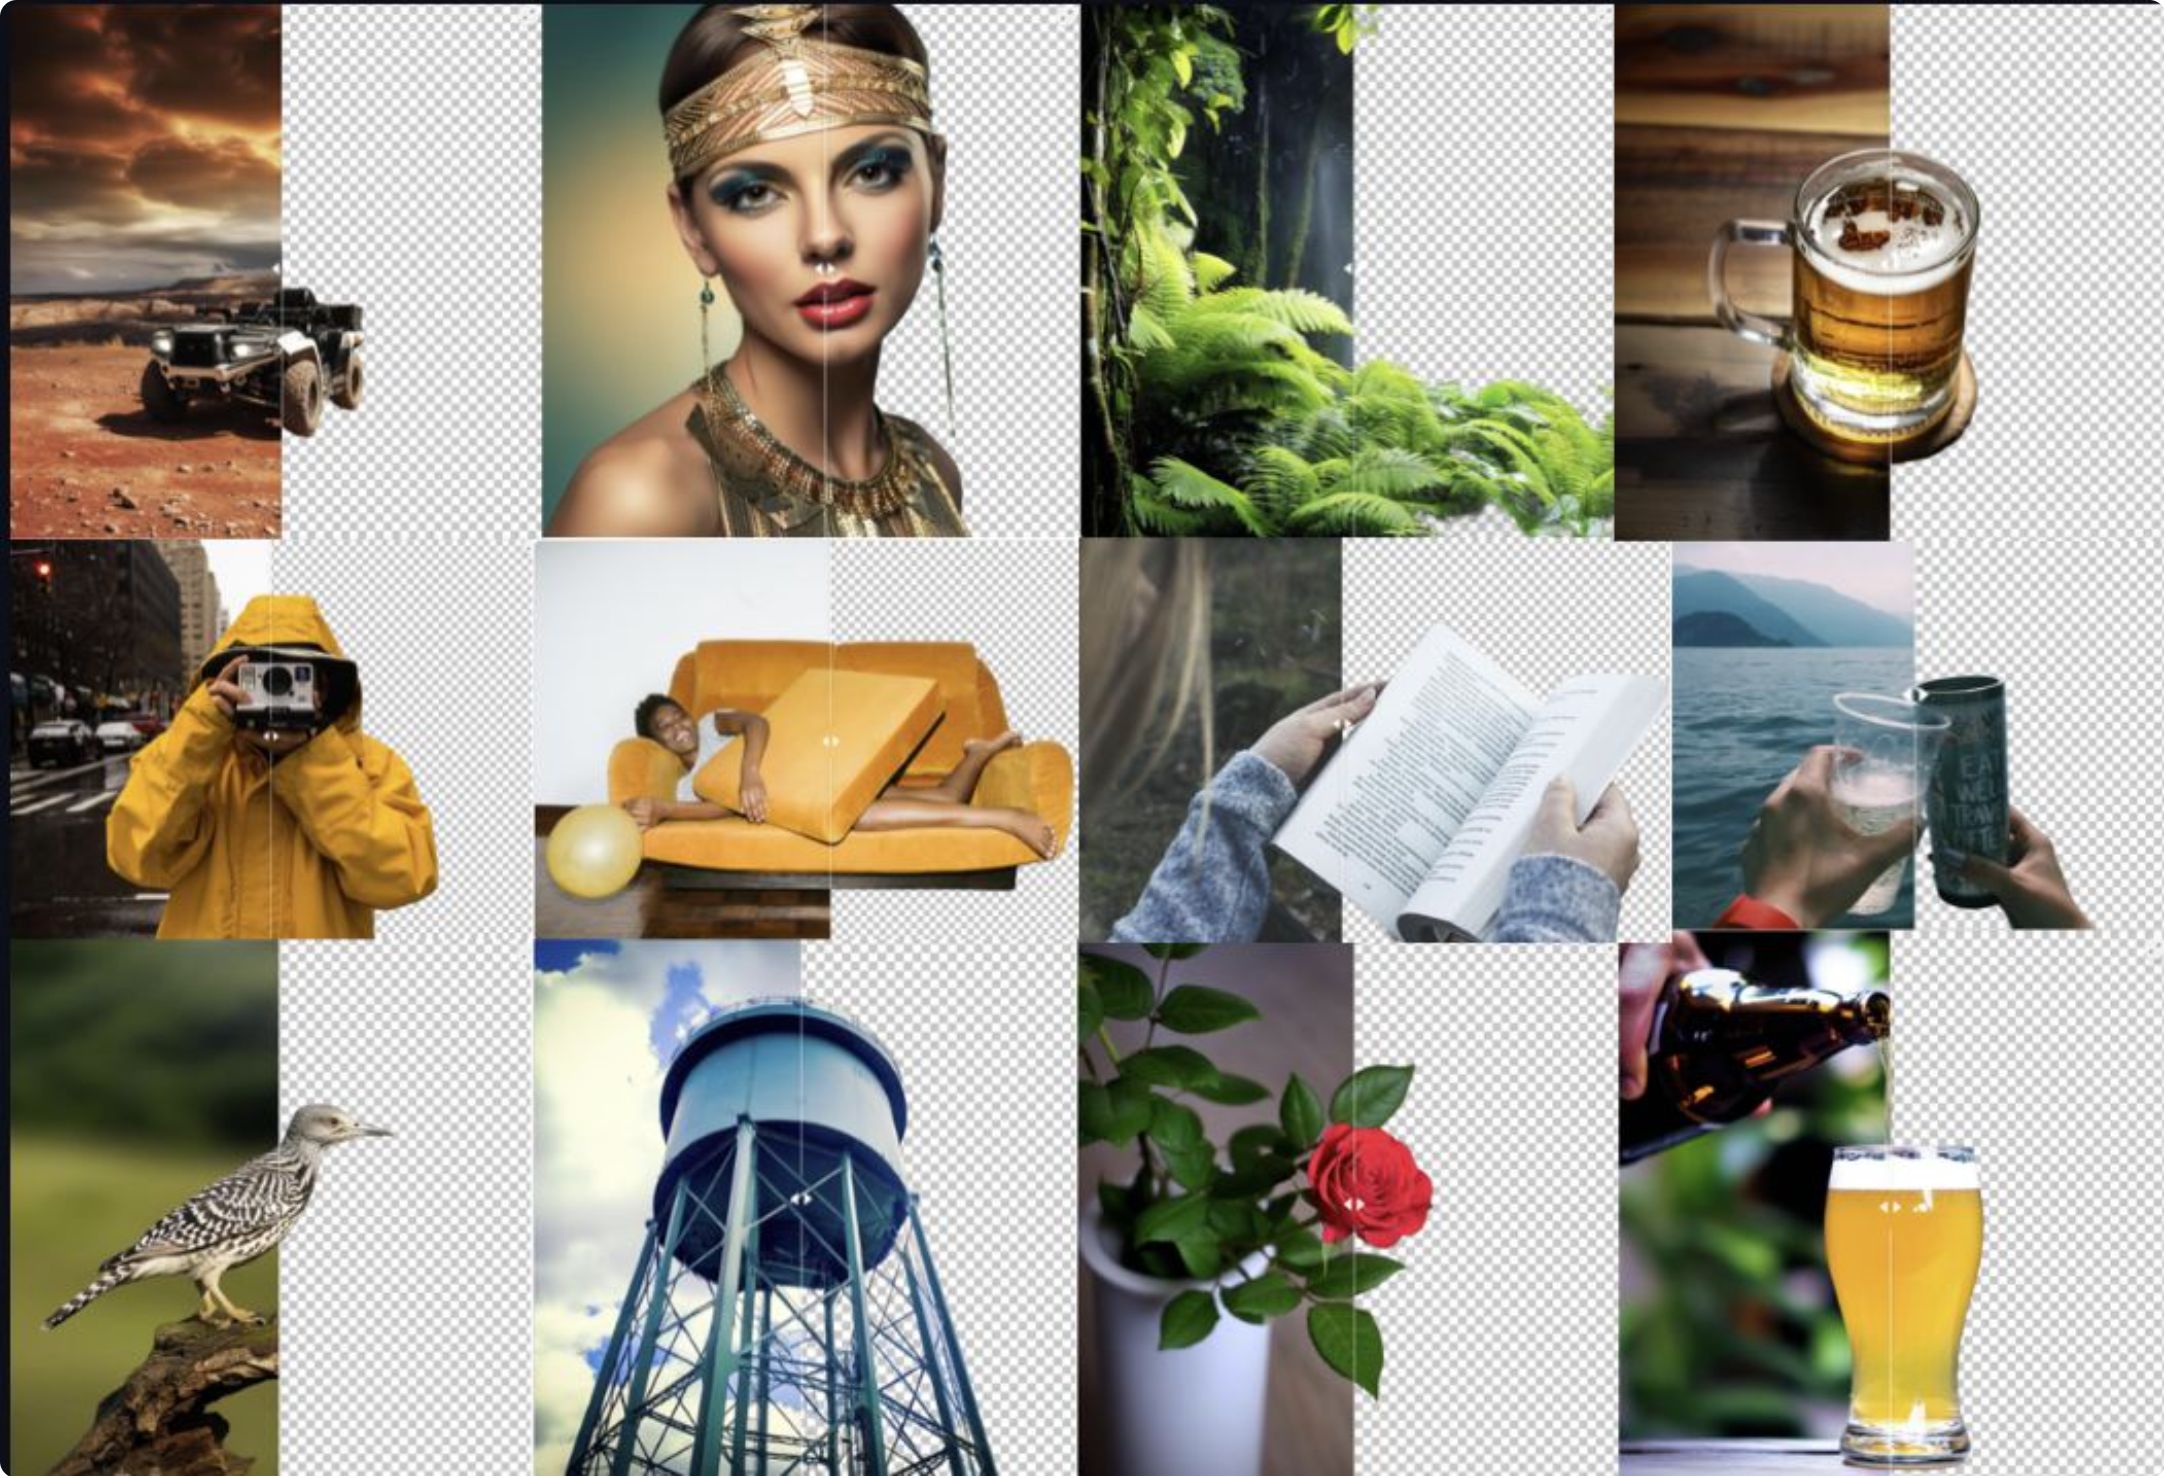
Segmentar objetos sólidos es fácil. Pero elementos como el pelo, el pelaje o el vidrio transparente son extremadamente difíciles de separar debido a sus bordes difusos y semitransparentes.
Modelo pensado para alpha matting: genera un canal alfa con transparencia gradual en los bordes en lugar de una máscara binaria, así que el recorte encaja en cualquier fondo sin efecto «pegatina». Su licencia no permite uso comercial sin acuerdo con BRIA.
De los algoritmos clásicos (SIFT, ORB…) a las redes.
¿Qué es? Encontrar puntos idénticos en dos fotos de la misma escena tomadas desde ángulos diferentes, a pesar de cambios en la perspectiva o la iluminación. Es la base de la reconstrucción 3D, la realidad aumentada y la localización de robots.
Una red que localiza los puntos más distintivos de la imagen (esquinas, texturas) y describe cada uno con un vector. Aguanta mejor que SIFT los cambios fuertes de luz y de punto de vista.
Un Transformer que compara los puntos de las dos imágenes, decide cuáles se corresponden y descarta los que no tienen pareja. Los errores geométricos que se le escapan se filtran después con RANSAC, como en la pantalla siguiente.
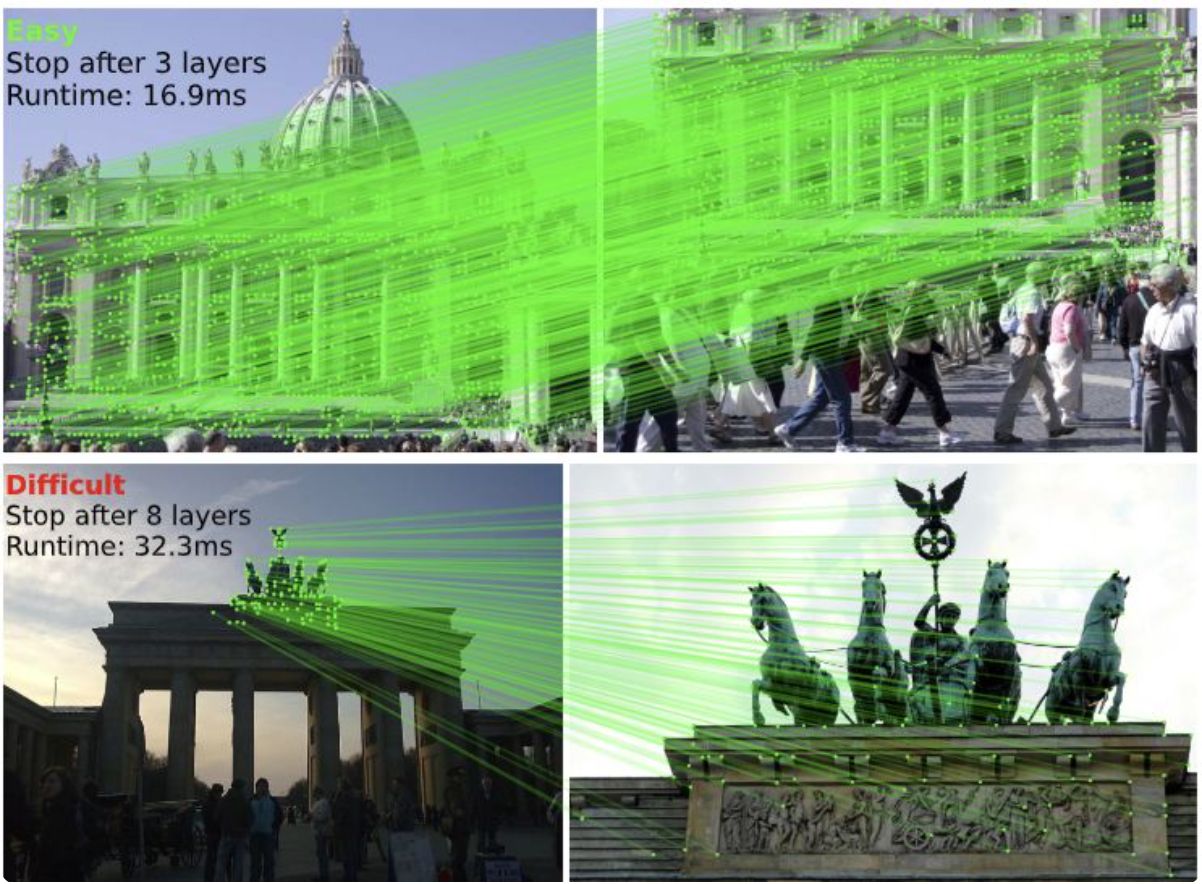
Dónde se nota: con cambios de luz (de día a noche), grandes variaciones de perspectiva y oclusiones, justo donde los métodos clásicos fallan más.
Un matcher devuelve más parejas de las que valen. El filtro que las separa no mira el aspecto, mira la geometría: mueve el umbral y comprueba cuáles encajan con la escena.
Esquema con una homografía real: la misma fachada vista desde otro sitio. Las parejas y su error se calculan en el navegador.
Estimación sólida
Parejas aceptadas9
Descartadas6
9 parejas coherentes y 6 descartadas. Las descartadas son las que se parecían sin estar en el mismo sitio.
Este umbral es el que se pasa a cv2.findHomography con RANSAC, y es el mando que más cambia el resultado en fotogrametría y en SLAM. Demasiado bajo y te quedas sin puntos para calcular; demasiado alto y una ventana confundida con otra te tuerce la pose de la cámara.
Esta página recoge el estado con 2 px de umbral. El procedimiento real es RANSAC: se eligen cuatro parejas al azar, se calcula la homografía que implican, se cuenta cuántas de las demás quedan por debajo del umbral de reproyección, y se repite unos cientos de veces quedándose con la hipótesis que más apoyo reúne. Esta pantalla enseña el paso de recuento con la homografía correcta ya fijada, que es donde se ve el compromiso. Las cuatro parejas muy alejadas son los errores típicos del matching: dos ventanas iguales en fachadas repetidas, un reflejo y un punto en el cielo, donde no hay textura estable. Las dos parejas intermedias, a 4,5 y 7,5 px, son las que deciden si el umbral está bien puesto: entran al subirlo y arrastran error a la estimación. Con imágenes de verdad, el umbral se elige en píxeles de la imagen original, así que cambiar la resolución de captura obliga a revisarlo.
Tres usos del matching.
Al identificar y conectar puntos coincidentes en múltiples fotos de una escena, se puede reconstruir la geometría 3D del objeto y la posición de la cámara en cada toma.
Un robot utiliza el matching de características para comprender su posición dentro de un entorno y construir un mapa del mismo, incluso mientras se mueve y explora.
Permite fusionar sin problemas varias imágenes superpuestas en una única foto de gran formato o una vista de 360 grados, eliminando duplicados y alineando las perspectivas.
Profundidad con una sola cámara y una sola foto.
Un modelo fundacional con encoder DINOv2. La V2 se entrenó con 595.000 imágenes sintéticas etiquetadas y 62 millones de imágenes reales con pseudoetiquetas.
Genera un mapa de profundidad (heatmap) donde el color indica la distancia relativa, revelando la estructura 3D subyacente.
Aguanta interiores, exteriores y escenas con mucho detalle. Cristales y espejos, que hacían fallar a la V1, los maneja mucho mejor gracias a los datos sintéticos; aun así, compruébalo con tus imágenes.
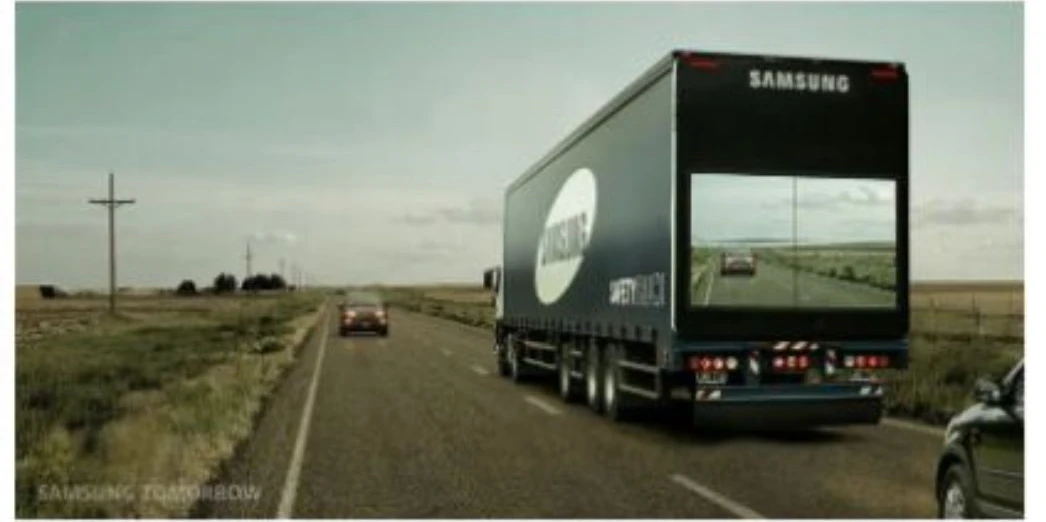
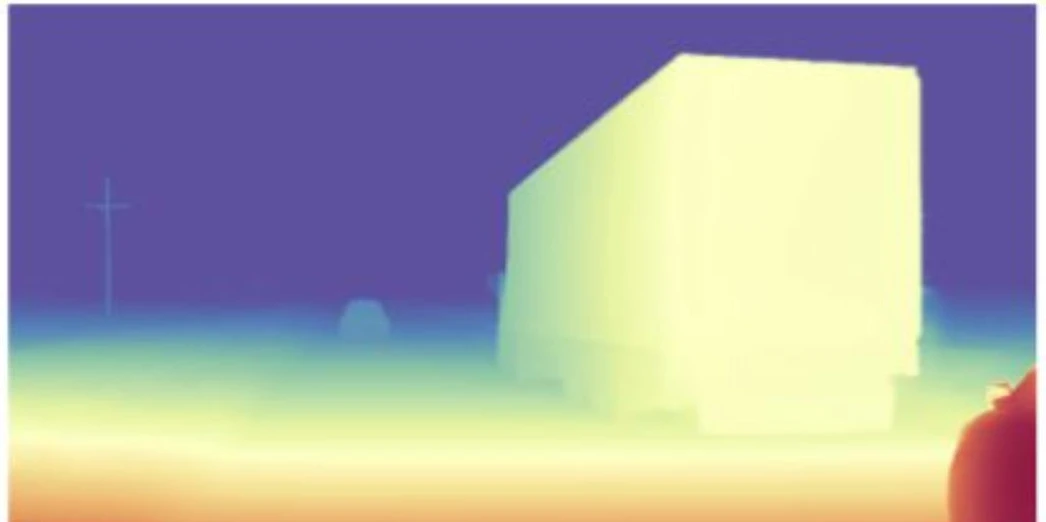
El mapa de profundidad de la pantalla anterior, usado como filtro: todo lo que queda más lejos que el corte se aclara. No hacen falta clases ni etiquetas: basta un umbral sobre la cercanía.
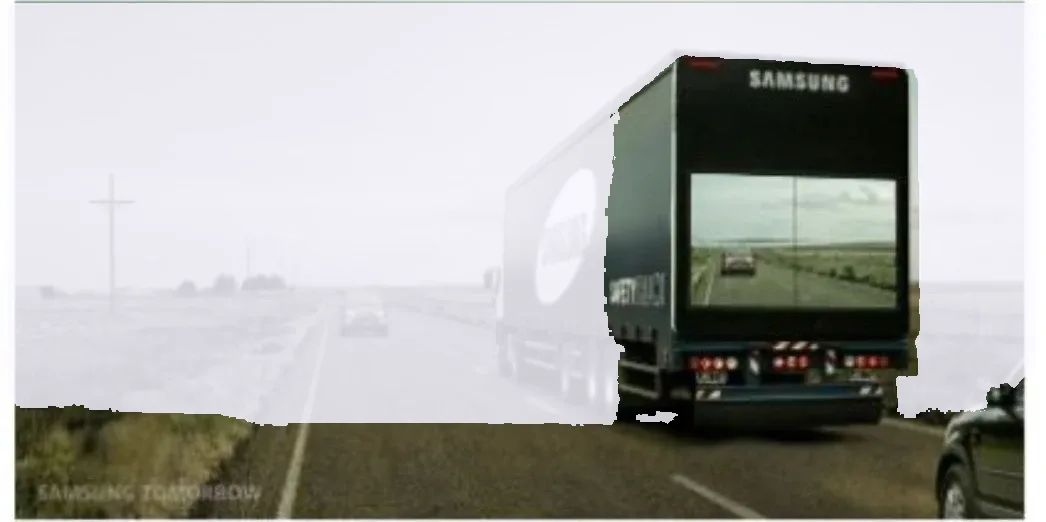
Imagen que se conserva42 %
Queda la trasera del camión, y la pantalla que muestra otra carretera sigue entera: el modelo le da la distancia del camión aunque enseñe una carretera lejana.
Mapa precalculado, el de la pantalla anterior; el corte se aplica en tu navegador. La escala es relativa: 100 no equivale a ninguna distancia en metros.
Esta página recoge el corte en 100 de 255, que conserva el 42 % de la imagen: la trasera del camión, el asfalto cercano y el coche de la derecha. El costado del camión se aleja de la cámara y queda fuera. La pantalla trasera, que muestra la carretera de delante, se conserva entera porque el modelo mide a qué distancia está la superficie de la pantalla; la carretera que aparece en ella no cuenta. Con el corte en 30 solo desaparece el cielo; por encima de 135 el camión entero queda al otro lado.
¿Para qué sirve un mapa de profundidad?
Desenfocar el fondo sintéticamente, creando imágenes con una profundidad de campo profesional y destacando el sujeto principal.
Permitir que robots y vehículos autónomos detecten obstáculos y comprendan su entorno 3D, utilizando solo una cámara de bajo coste.
Convertir una foto plana en una estructura 3D navegable (malla o nube de puntos) al combinar la imagen RGB con su mapa de profundidad.
Un umbral sobre el mapa elimina lo que queda más lejos (o más cerca) de lo que interesa, sin clases ni etiquetas.
Profundidad relativa vs. métrica. Estos modelos suelen estimar profundidad relativa (mapas de calor). Para obtener metros reales se necesita calibración de cámara o un modelo de profundidad métrica; Depth Anything V2 tiene variantes métricas para interior y exterior.
Un mapa normalizado ordena distancias, pero no las mide.
Respuesta C. Exacto: necesitas un modelo métrico, calibración u otra referencia de escala.
Un mapa relativo dice qué está más cerca que qué. Para responder «a cuántos metros» hacen falta calibración de cámara, una referencia conocida o un modelo entrenado para profundidad métrica.
Los mismos modelos, combinados de otra manera, resuelven problemas muy distintos. Lo que cambia de un sector a otro es qué hay que vigilar.
Detectar y seguir personas y vehículos, contar los que entran en una zona, avisar de una caída con la pose. RF-DETR con un seguidor (tema 1) y ViTPose (este tema).
Ojo: el Reglamento europeo de IA prohíbe desde febrero de 2025, salvo excepciones tasadas, la identificación biométrica remota en tiempo real en espacios públicos con fines policiales y el reconocimiento de emociones en el trabajo.
Defectos sin ejemplos de defecto, conteo de piezas, lectura de lotes y etiquetas, medidas con máscaras. DINOv3 con banco de normalidad (tema 4), SAM (tema 5) y OCR (este tema).
Ojo: luz y encuadre estables, y un umbral fijado con piezas buenas.
Saber qué está cerca con una sola cámara, recortar el objeto que hay que coger, encontrar objetos nuevos por su nombre. Depth Anything (este tema), SAM 2 (tema 5) y Grounding DINO (tema 3).
Ojo: esta profundidad es relativa; para coger un objeto hacen falta metros.
Vehículos, peatones y señales, la calzada separada del resto, distancias y matrículas. Detectores en tiempo real (tema 1), segmentación (tema 5), profundidad y OCR (este tema).
Ojo: tiempo real en el hardware del coche, y noche, lluvia y contraluz en los datos de validación.
Las prohibiciones del artículo 5 del Reglamento (UE) 2024/1689 se aplican desde el 2 de febrero de 2025. Entre ellas están la identificación biométrica remota en tiempo real en espacios de acceso público con fines policiales, salvo excepciones tasadas, y el reconocimiento de emociones en el lugar de trabajo y en centros educativos, salvo por motivos médicos o de seguridad. Contar personas sin identificarlas no entra en esas prohibiciones, pero sigue sujeto al RGPD. Para la profundidad métrica hace falta un modelo entrenado para ello, una cámara estéreo o calibración.
Lo mínimo para arrancar cada una, con el mismo código que usa el cuaderno. Elige la tarea.
# Pose: personas y sus 17 puntos
import torch
from PIL import Image
from transformers import AutoProcessor, RTDetrForObjectDetection, VitPoseForPoseEstimation
image = Image.open("mi_imagen.jpg").convert("RGB")
# 1. Encontrar a las personas
det_processor = AutoProcessor.from_pretrained("PekingU/rtdetr_r50vd_coco_o365")
detector = RTDetrForObjectDetection.from_pretrained("PekingU/rtdetr_r50vd_coco_o365")
with torch.no_grad():
detections = detector(**det_processor(images=image, return_tensors="pt"))
found = det_processor.post_process_object_detection(
detections, target_sizes=[(image.height, image.width)], threshold=0.5)[0]
person_id = [i for i, name in detector.config.id2label.items() if name == "person"][0]
boxes = found["boxes"][found["labels"] == person_id].numpy()
boxes[:, 2:] -= boxes[:, :2] # ViTPose quiere x, y, ancho, alto
# 2. Ponerles el esqueleto
pose_processor = AutoProcessor.from_pretrained("usyd-community/vitpose-plus-base")
pose_model = VitPoseForPoseEstimation.from_pretrained("usyd-community/vitpose-plus-base")
inputs = pose_processor(image, boxes=[boxes], return_tensors="pt")
inputs["dataset_index"] = torch.tensor([0]) # 0: los 17 puntos de COCO
with torch.no_grad():
poses = pose_model(**inputs)
people = pose_processor.post_process_pose_estimation(poses, boxes=[boxes])[0]
print(len(people), people[0]["keypoints"].shape) # personas, (17, 2)
# OCR: todo el texto de la imagen, línea a línea
import torch
from PIL import Image
from transformers import AutoModelForImageTextToText, AutoProcessor
image = Image.open("mi_documento.jpg").convert("RGB")
processor = AutoProcessor.from_pretrained("stepfun-ai/GOT-OCR-2.0-hf")
model = AutoModelForImageTextToText.from_pretrained("stepfun-ai/GOT-OCR-2.0-hf", device_map="auto")
inputs = processor(image, return_tensors="pt").to(model.device, model.dtype)
with torch.no_grad():
ids = model.generate(**inputs, do_sample=False, tokenizer=processor.tokenizer,
stop_strings="<|im_end|>", max_new_tokens=500)
print(processor.decode(ids[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True))
# Superresolución: el doble de lado
import numpy as np
import torch
from PIL import Image
from transformers import AutoImageProcessor, Swin2SRForImageSuperResolution
image = Image.open("mi_imagen.jpg").convert("RGB")
processor = AutoImageProcessor.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
model = Swin2SRForImageSuperResolution.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
with torch.no_grad():
output = model(**processor(image, return_tensors="pt"))
pixels = output.reconstruction.squeeze().clamp(0, 1).permute(1, 2, 0).numpy()
Image.fromarray((pixels * 255).astype(np.uint8)).save("ampliada.png")
# Fondo: las personas recortadas sobre fondo transparente
import numpy as np
import torch
from PIL import Image
from transformers import AutoProcessor, RTDetrForObjectDetection, Sam2Model, Sam2Processor
image = Image.open("mi_imagen.jpg").convert("RGB")
# 1. Encontrar a las personas
det_processor = AutoProcessor.from_pretrained("PekingU/rtdetr_r50vd_coco_o365")
detector = RTDetrForObjectDetection.from_pretrained("PekingU/rtdetr_r50vd_coco_o365")
with torch.no_grad():
detections = detector(**det_processor(images=image, return_tensors="pt"))
found = det_processor.post_process_object_detection(
detections, target_sizes=[(image.height, image.width)], threshold=0.5)[0]
boxes = [b.tolist() for b, l in zip(found["boxes"], found["labels"])
if detector.config.id2label[l.item()] == "person"]
# 2. Convertir cada caja en una silueta con SAM 2
sam_processor = Sam2Processor.from_pretrained("facebook/sam2.1-hiera-small")
sam = Sam2Model.from_pretrained("facebook/sam2.1-hiera-small")
inputs = sam_processor(images=image, input_boxes=[boxes], return_tensors="pt")
with torch.no_grad():
outputs = sam(**inputs)
masks = sam_processor.post_process_masks(outputs.pred_masks, inputs["original_sizes"])[0]
best = outputs.iou_scores[0].argmax(dim=-1) # la mejor de las 3 máscaras de cada caja
silhouette = masks[torch.arange(len(boxes)), best].any(dim=0).numpy()
alpha = (silhouette * 255).astype(np.uint8)
Image.fromarray(np.dstack([np.array(image), alpha])).save("sin_fondo.png")
print(len(boxes), "persona(s), silueta de", int(silhouette.sum()), "píxeles")
# Profundidad: distancia relativa
from transformers import pipeline
depth = pipeline("depth-estimation", model="depth-anything/Depth-Anything-V2-Small-hf")
result = depth("mi_imagen.jpg")
result["depth"].save("profundidad.png") # claro es cerca, oscuro lejos
# Matching: correspondencias entre dos fotos
from transformers import pipeline
matcher = pipeline("keypoint-matching", model="ETH-CVG/lightglue_superpoint")
matches = matcher(["vista_1.jpg", "vista_2.jpg"], threshold=0.9)
print(len(matches), matches[0]) # un punto en cada foto y su puntuación
Top-down: RT-DETR encuentra a las personas y ViTPose les pone 17 puntos. ViTPose no busca personas por su cuenta; sin las cajas no hace nada.
Las recetas están ejecutadas el 23 de octubre de 2026 con transformers 5.20, la versión que trae Colab. En la versión 5 ya no existen las tareas de pipeline image-to-text ni image-to-image, y nunca ha existido una de keypoint-detection: por eso pose, OCR y superresolución cargan el modelo directamente, igual que el cuaderno. Para quitar el fondo el curso usaba RMBG-1.4, que ejecuta código de su repositorio y no permite uso comercial; ahora se encadenan RT-DETR y SAM 2. El cuaderno ejecuta cinco de las seis tareas con imágenes de ejemplo, todas menos matching, y deja el encadenado como ejercicio.
Seis comprobaciones comunes a tareas muy distintas.
Pose, OCR, superresolución, fondo y profundidad sobre tus propias imágenes.
Cada tarea es independiente: puedes ejecutar solo la que te interese. La ampliación consiste en encadenar dos pipelines, por ejemplo estimar profundidad y usar un umbral para recortar el fondo, o pasar un recorte con superresolución al OCR. Anota qué modelo, qué versión y qué error observas en cada paso.